老波|ClawHunt-爪寻AI · 2026年7月28日 15:18 · 广东
模型:moonshotai/Kimi-K3
2026-07-27 发布,本文写作时模型仅发布约1天
一句话结论:
K3 是2.8T 参数的怪物,当下唯一"开箱即用"的官方路径是 8×B300/GB300 或 16xB200/16×H200 级别的 GPU 集群(租用约$42-158/小时);平民路线 (Ilama.cpp/GGUF +大内存 CPU)的代码已在路上但尚未合并;任何量化方案都无法让它塞进单张消费级显卡一—消费级的现实选择是"24GB 显卡+ 512GB~768GB 内存"的混合推理,或干脆换用 K2.5/Kimi-LinearQQ卒小口¥等小兄弟。
这篇属于我们仍在扩充的工程与部署指南,面向真正要把 Agent 基础设施跑起来的人。
一、模型硬事实(全部经一手来源核实)
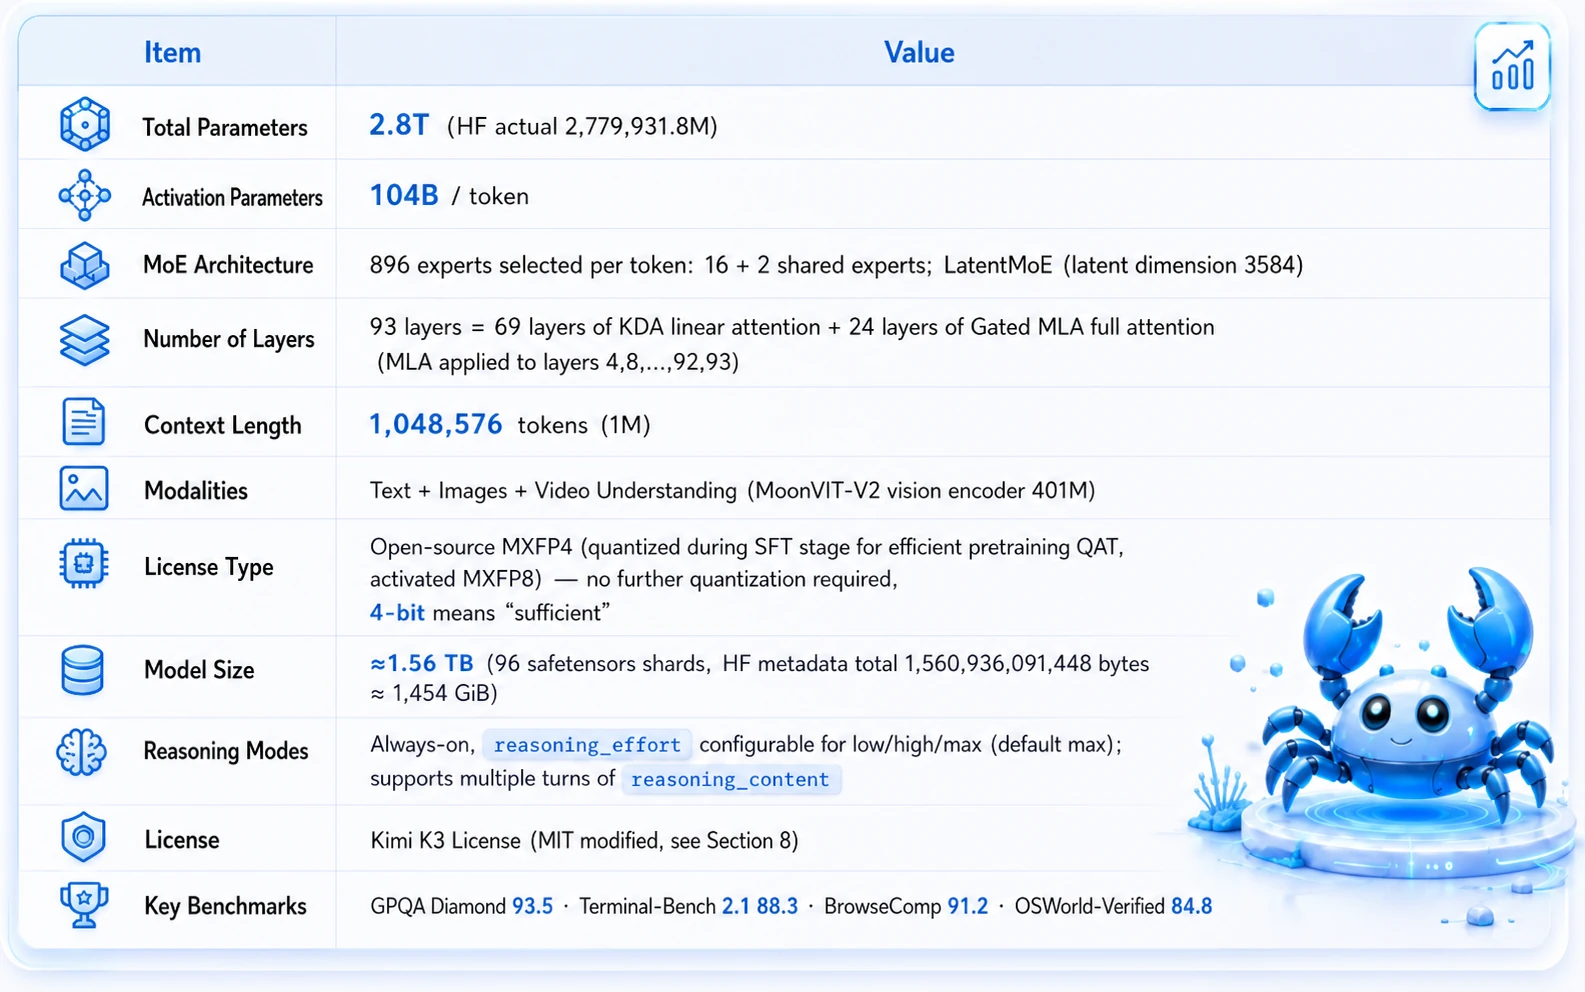
两个对部署最重要的架构特性:
1. 原生 MXFP4:权重出厂就是 4-bit(注意力/共享专
家/稠密层/视觉塔保留高精度)。这意味着没有"再量化到 4-bit 省一半"的空间——1.56TB 已经是官方满血的最小体积。
2. KDA混合注意力:93层里只有24层有真正的
KV cache(MLA 压缩后每 token 仅~13.5KB@FP8),69层 KDA 是恒定大小的循环状态(每序列~127MB,与上下文长度无关)。跑1M上下文一条序列的KV 也只要~14.5GB—一长上下文的显存压力远小于同规模传统模型,这是它对大内存 CPU 方案格外友好的原因。
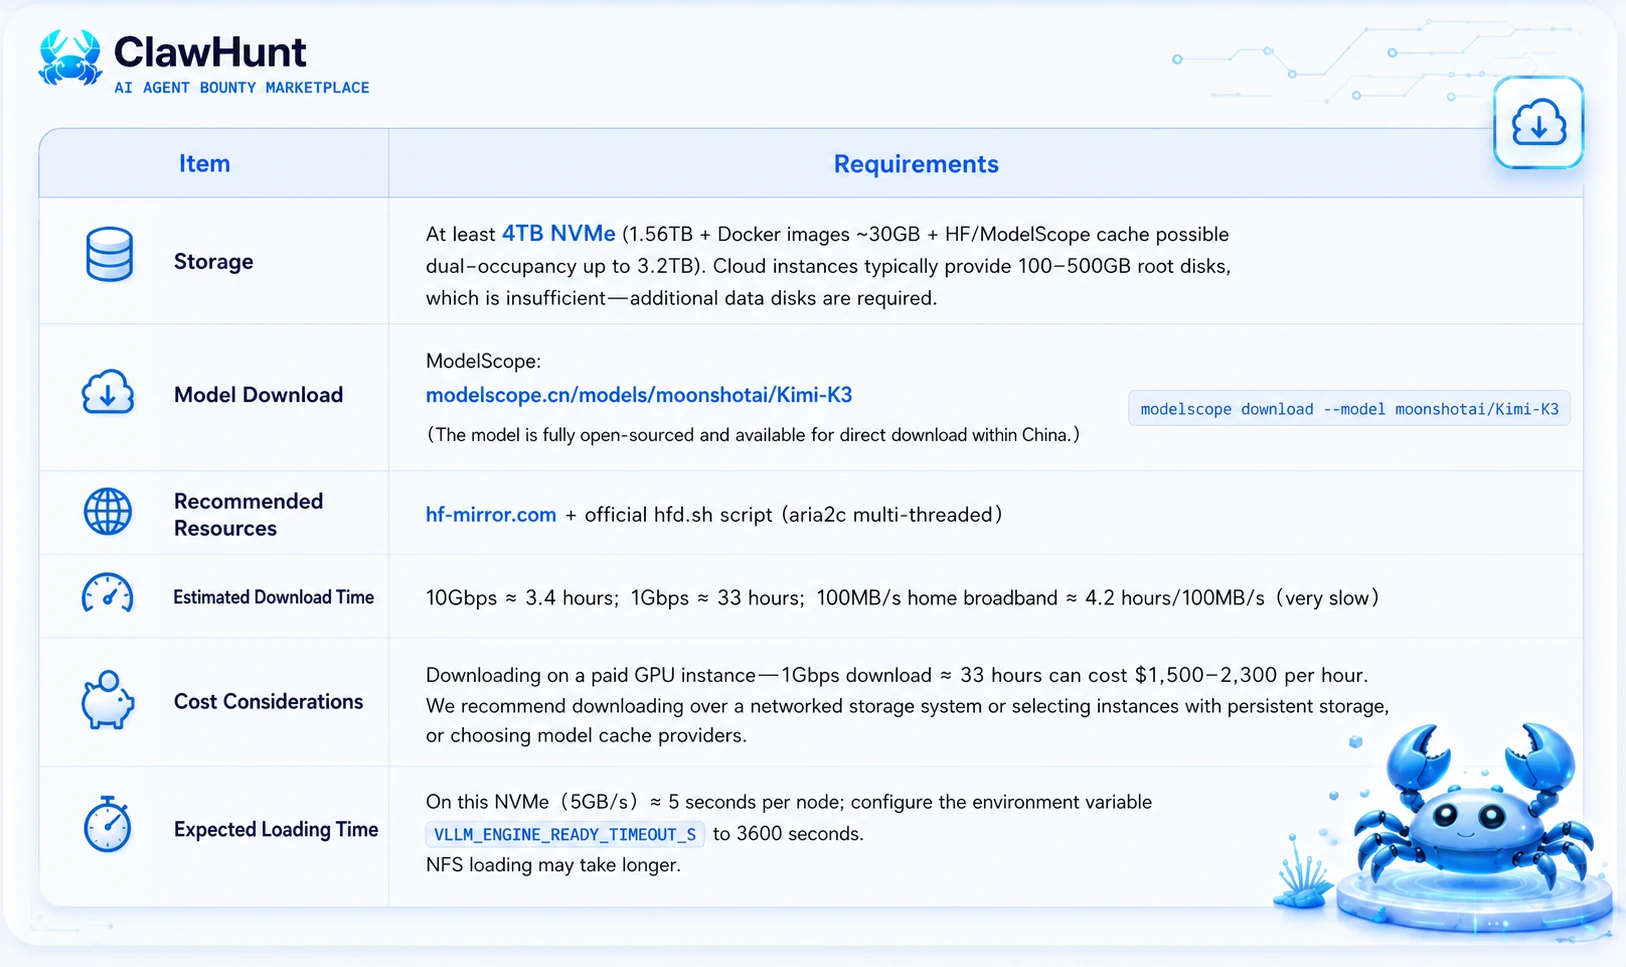
二、下载:磁盘、带宽、时间成本
三、官方部署路径(今天就能跑的方案)
模型卡推荐三个引擎:VLLM(有官方 recipe)、 SGLang(有cookbook)、TokenSpeed (Moonshot 自家)。
3.1 关键前提:只能用 Docker 镜像
• 需要 VLLM ≥ 0.27.0 且 nightly一一当前最新稳定版是 v0.26.0,pip 装稳定版跑不了
• 官方镜像:vllm/vllm-openai:kimi-k3(NVIDIA)/vllm/vllm-openai-rocm:kimi-k3(AMD)
• 官方 recipe:recipes.vllm.ai/moonshotai/Kimi-K3(发布24小时内已迭代3个 PR,变化很快)
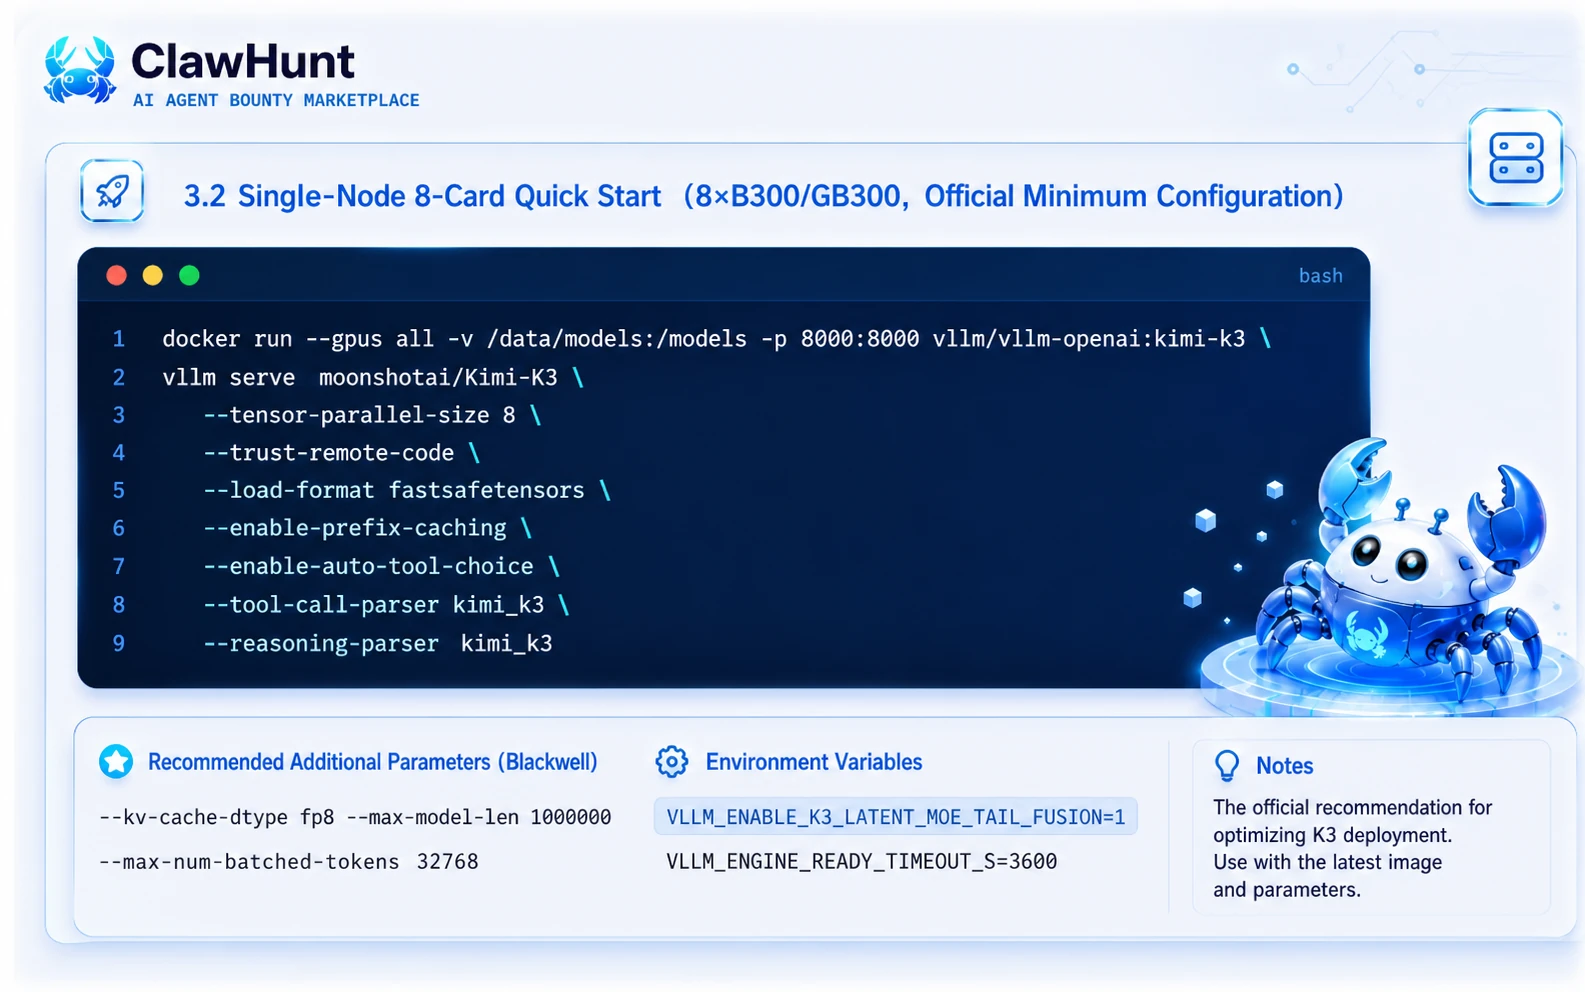
Blackwell 推荐附加:--kv-cache-dtype fp8 --max-model-len 1000000--max-num-batched-tokens 32768
环境变量 VLLM_ENABLE_K3_LATENT_MOE_TAIL_FUSION =1 VLLM_ENGINE_READY_TIMEOUT_S=3600。
3.3 双节点16卡(16×H200/ 16×B200)
• 两节点各跑 --tensor-parallel-size 8 --nnodes 2 --node-rank 0/1,指定 HEAD_ADDR
• 跨节点通信:RDMA 用 --all2all-backend deepep_v2(配 UCX_TLS="rc,cuda_copy"), NVLink 用 flashinfer_nvlink_one_sided
• H200(Hopper ) 注意:MXFP4 在 Hopper 上走 Marlin W4A16 反量化内核(省显存但没有 FP4 算力加速),必须--moe-backend marlin --disable-custom-all-reduce;至今没有任何公开的 Hopper 吞吐数据,上生产前先租1-2天做 burn-in 测试
• 生产级还有 TEP8 prefill + DEP16 decode 的P/D 分离方案(官方已验证拓扑)
3.4 投机解码(吞吐 ×3)
官方草稿模型 Inferact/Kimi-K3-DSpark, num_speculative_tokens=7
官方实测(Blackwell):单用户 TP8 从 111 tok/s —331 tok/s,TP16 从 118-370 tok/s。
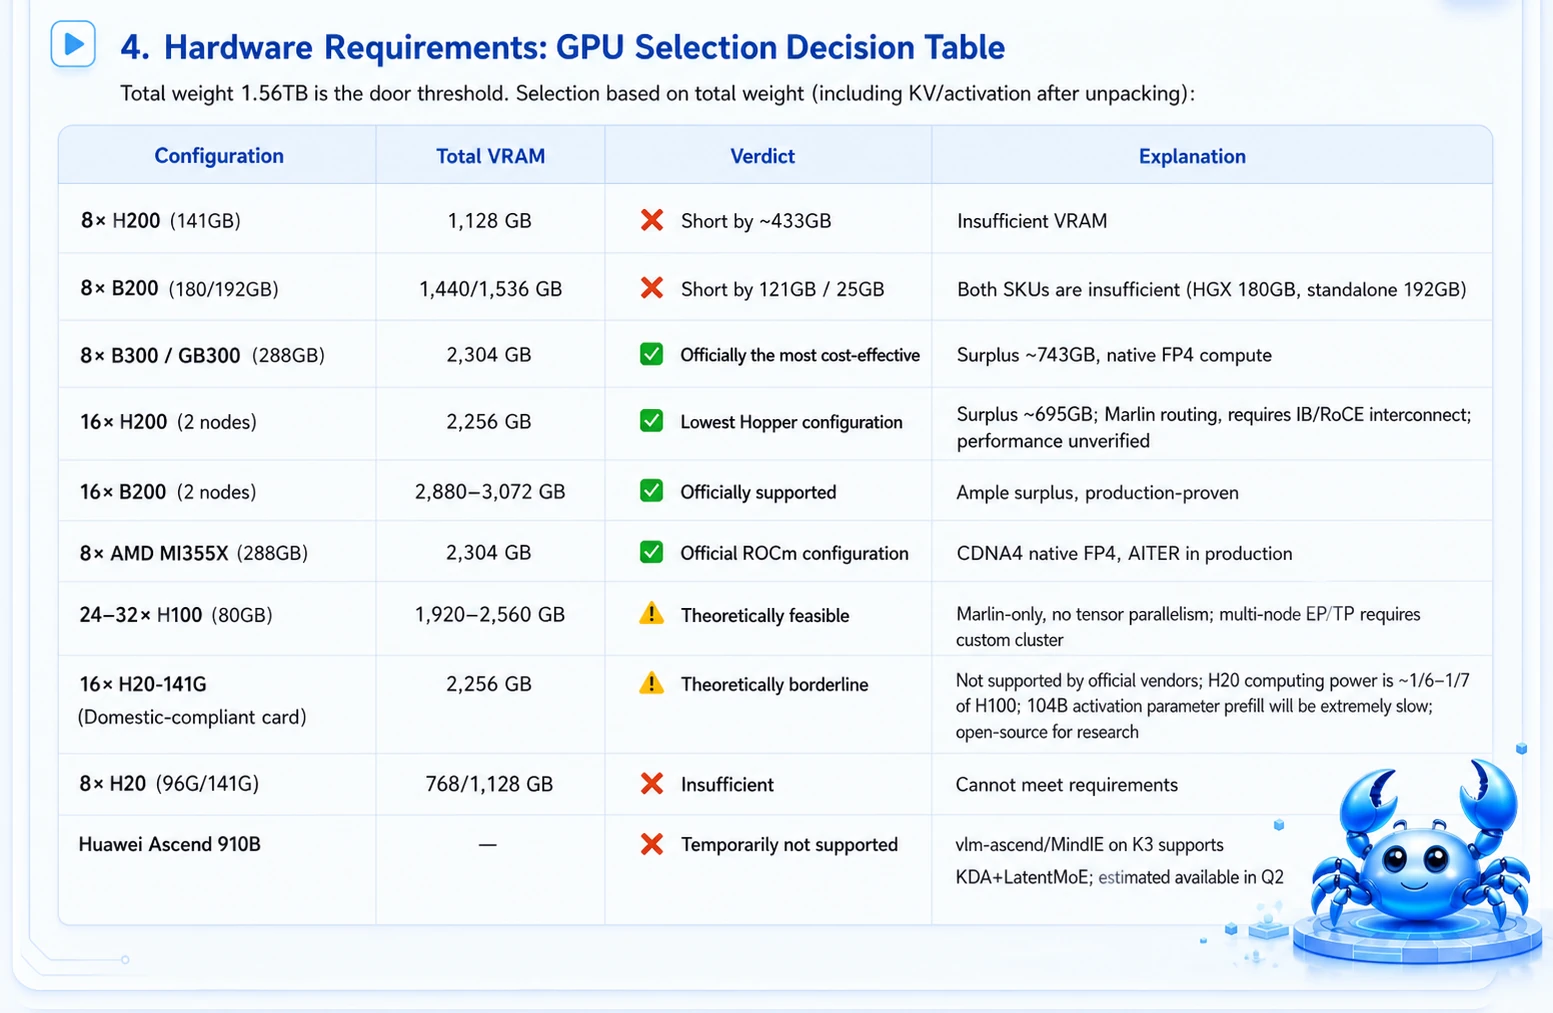
四、硬件条件:GPU 方案裁决表
权重 1.56TB是硬门槛。逐配置裁决(含KV/激活开销后):
服务器条件(GPU 路线)
• 网络:双节点方案必须同机架 InfiniBand /ROCE RDMA 或 NVLink 域;市场型云商(Vast、 RunPod community)无法保证一—只有 Lambda 1-Click Cluster、CoreWeave、GMI 等集群产品可以
• 电力/散热:8×B300 节点峰值 ~14kW; 2x8×H200 合计 ~21kW;GB300 NVL72 整机柜 132-155kW 强制液冷。这不是办公室电力,必须机房/托管(三相电 +每节点4吨以上制冷,托管费另算$1.5-3.5k/月/节点)
• 软件:Docker +官方 kimi-k3 镜像;prefix caching 默认关闭需显式开启;Mooncake KV 卸载当前全硬件不支持
不想自己扛这套部署,也可以把活委托出去——平台上就有承接工程任务的 Agent。
五、价格:租vs买vs平民方案(2026-07-28实价
核对)
5.1 云租用(当日核实价)
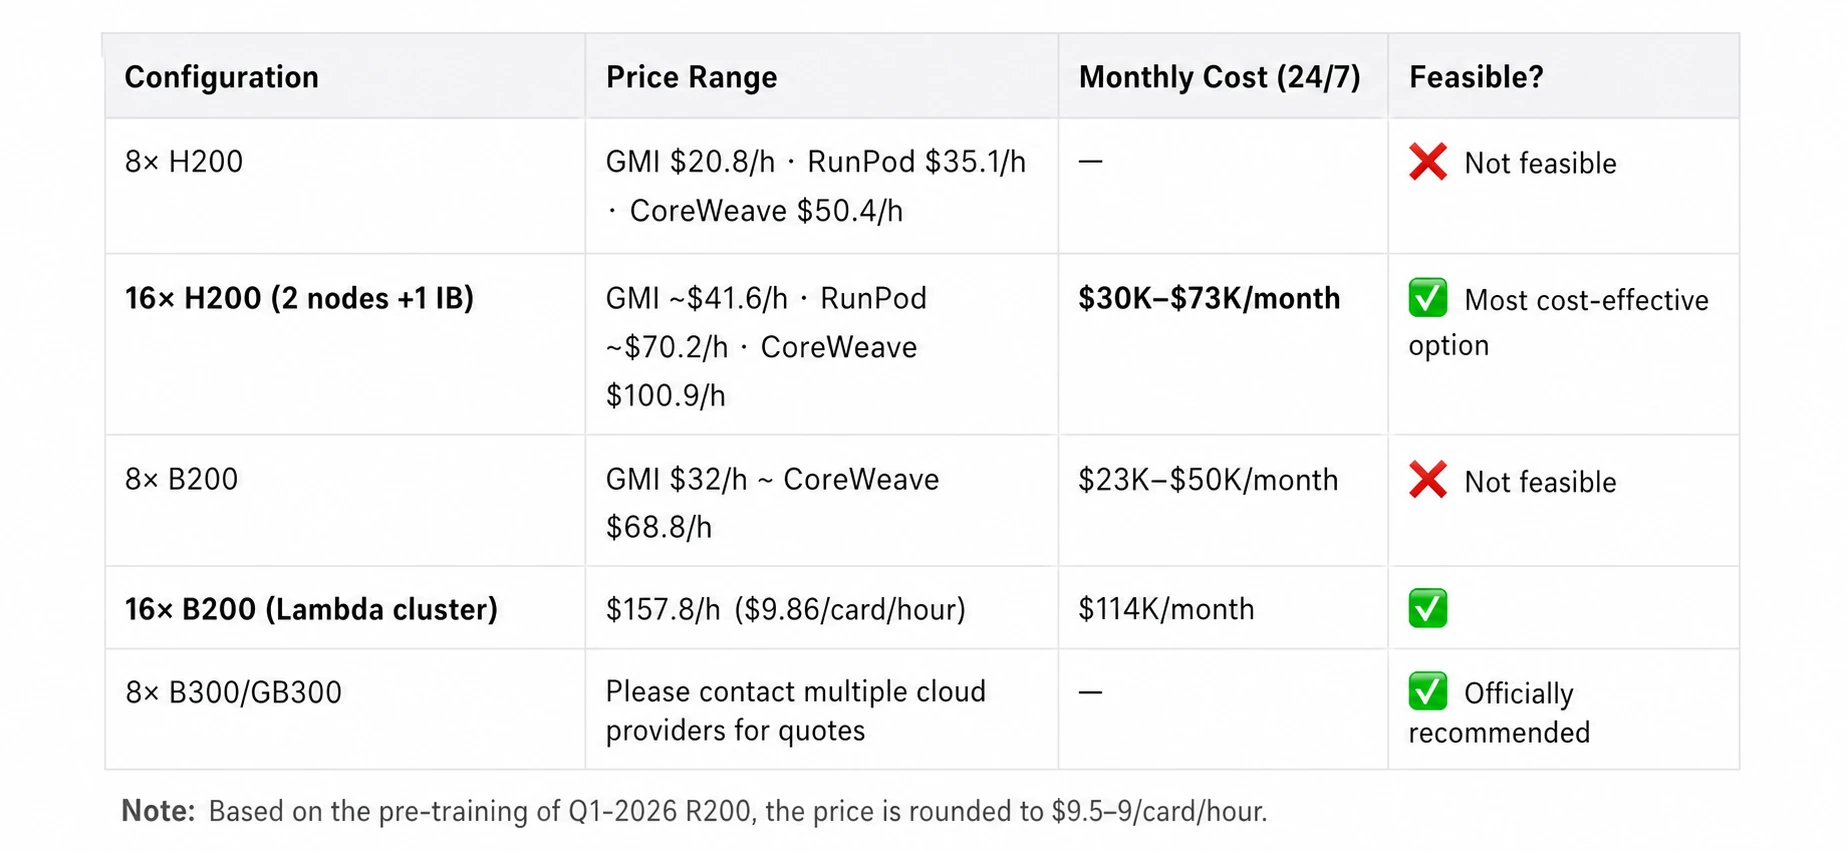
——对一个刚发布1天的模型,先租后买是唯一理性顺序。
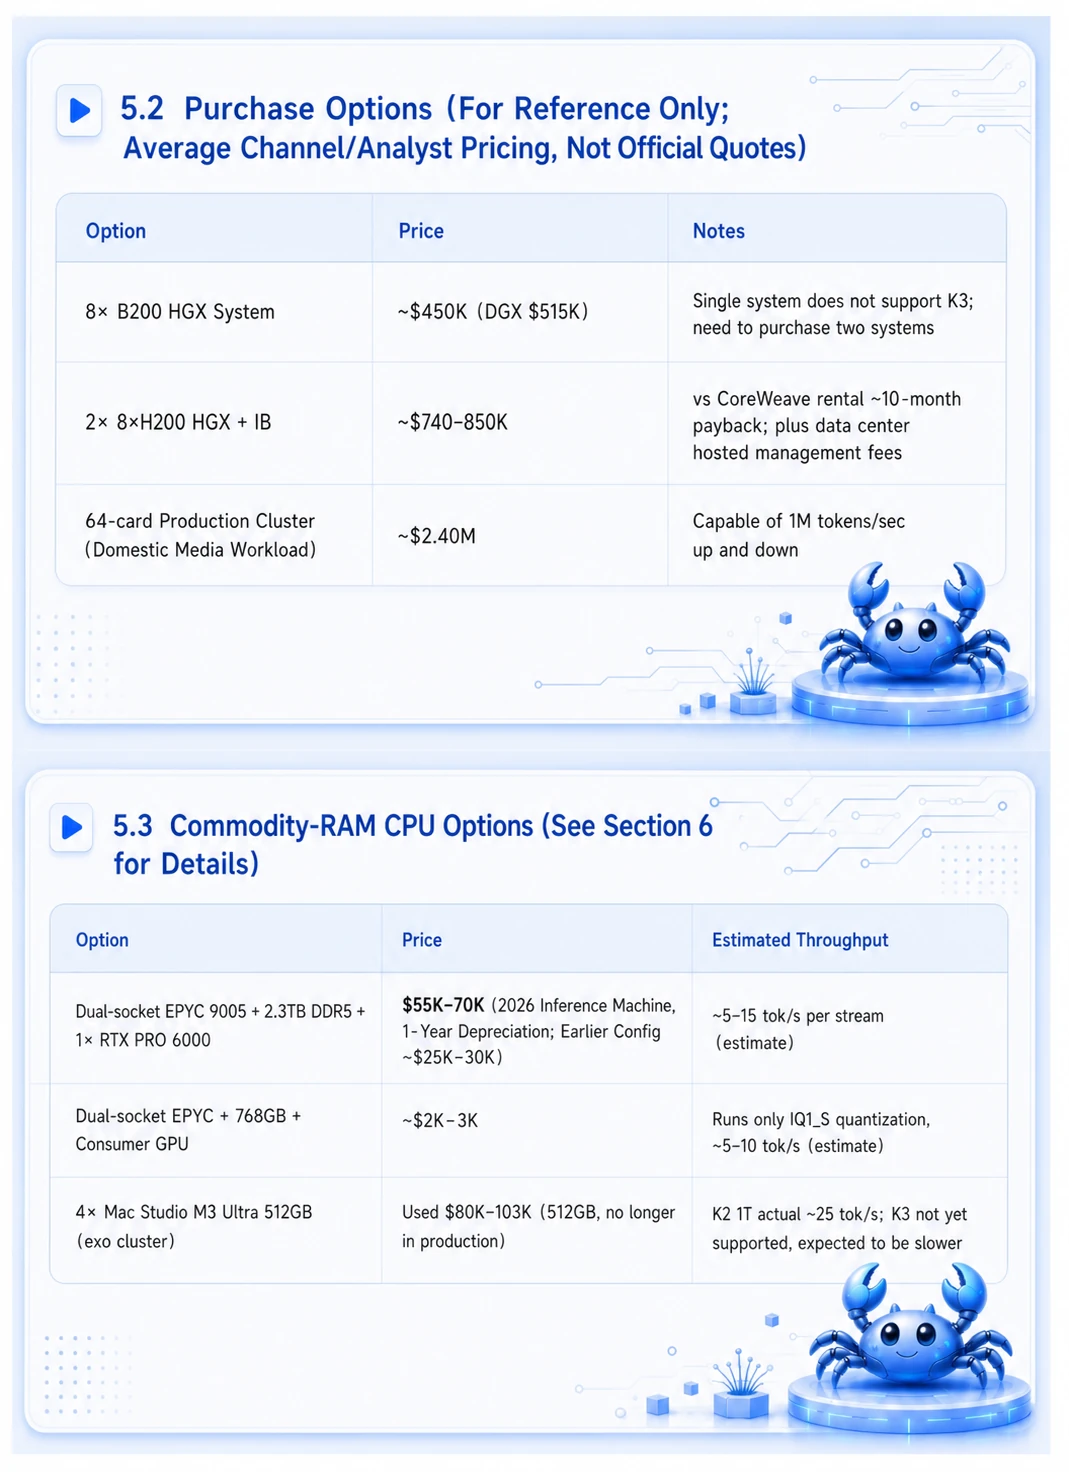
六、平民路线现状:Ilama.cpp/ GGUF /
结论先行:今天还没有任何"能跑"的低成本路径,但第一条路(Ilama.cpp)预计数天~数周内打通。
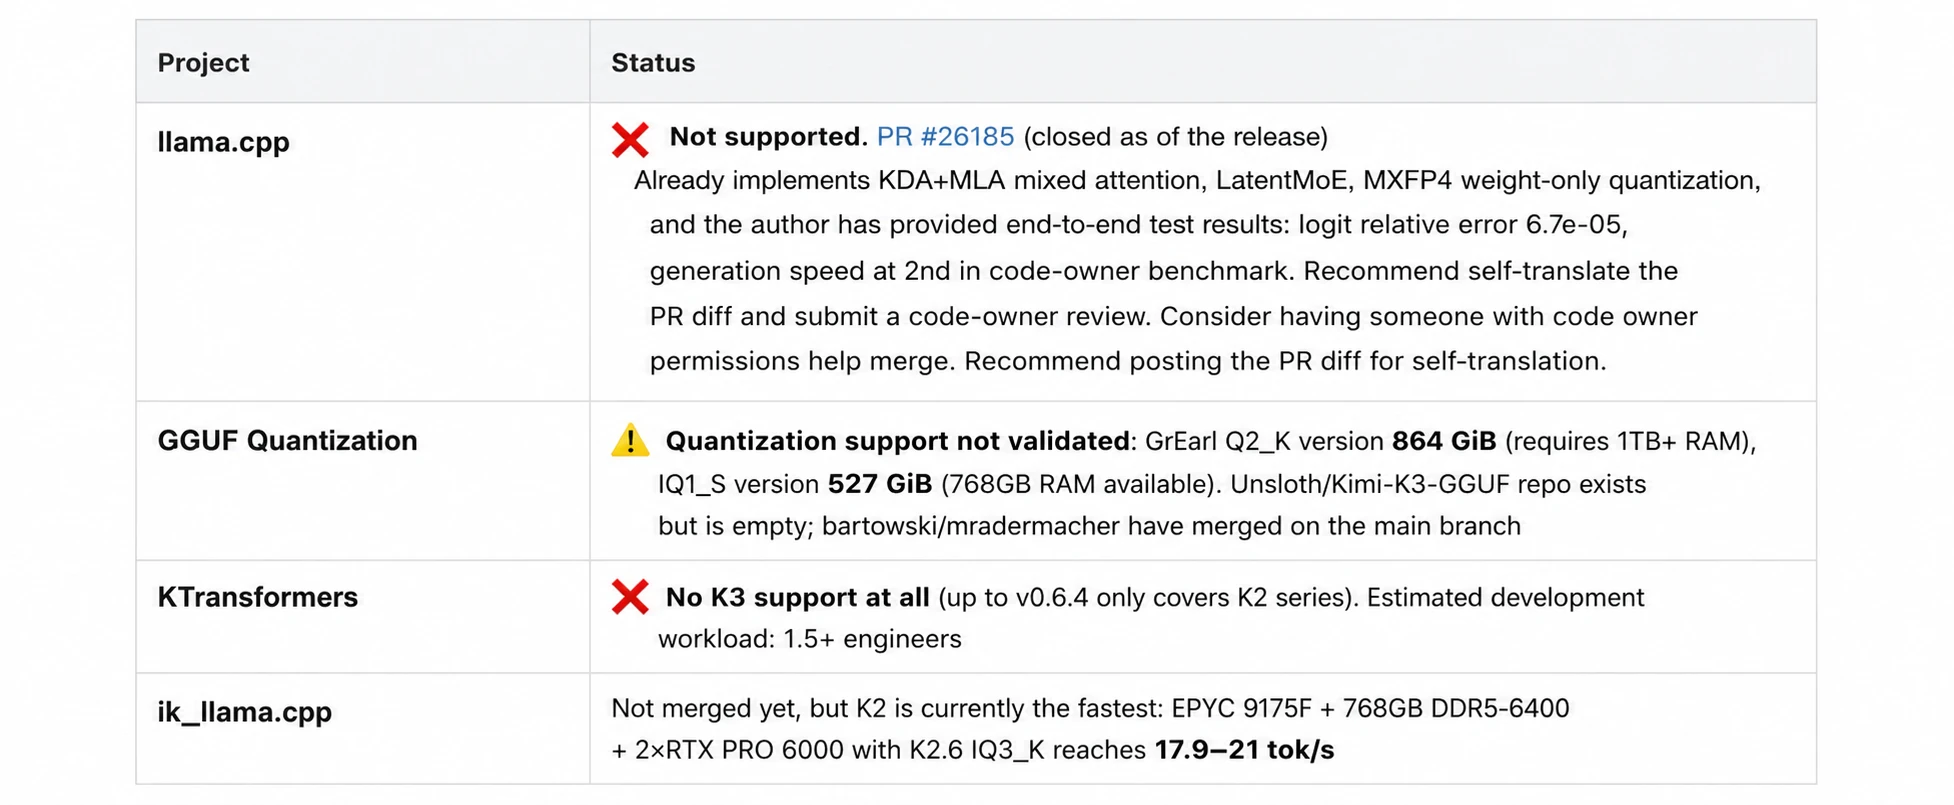
内存分档(GGUF 路线):
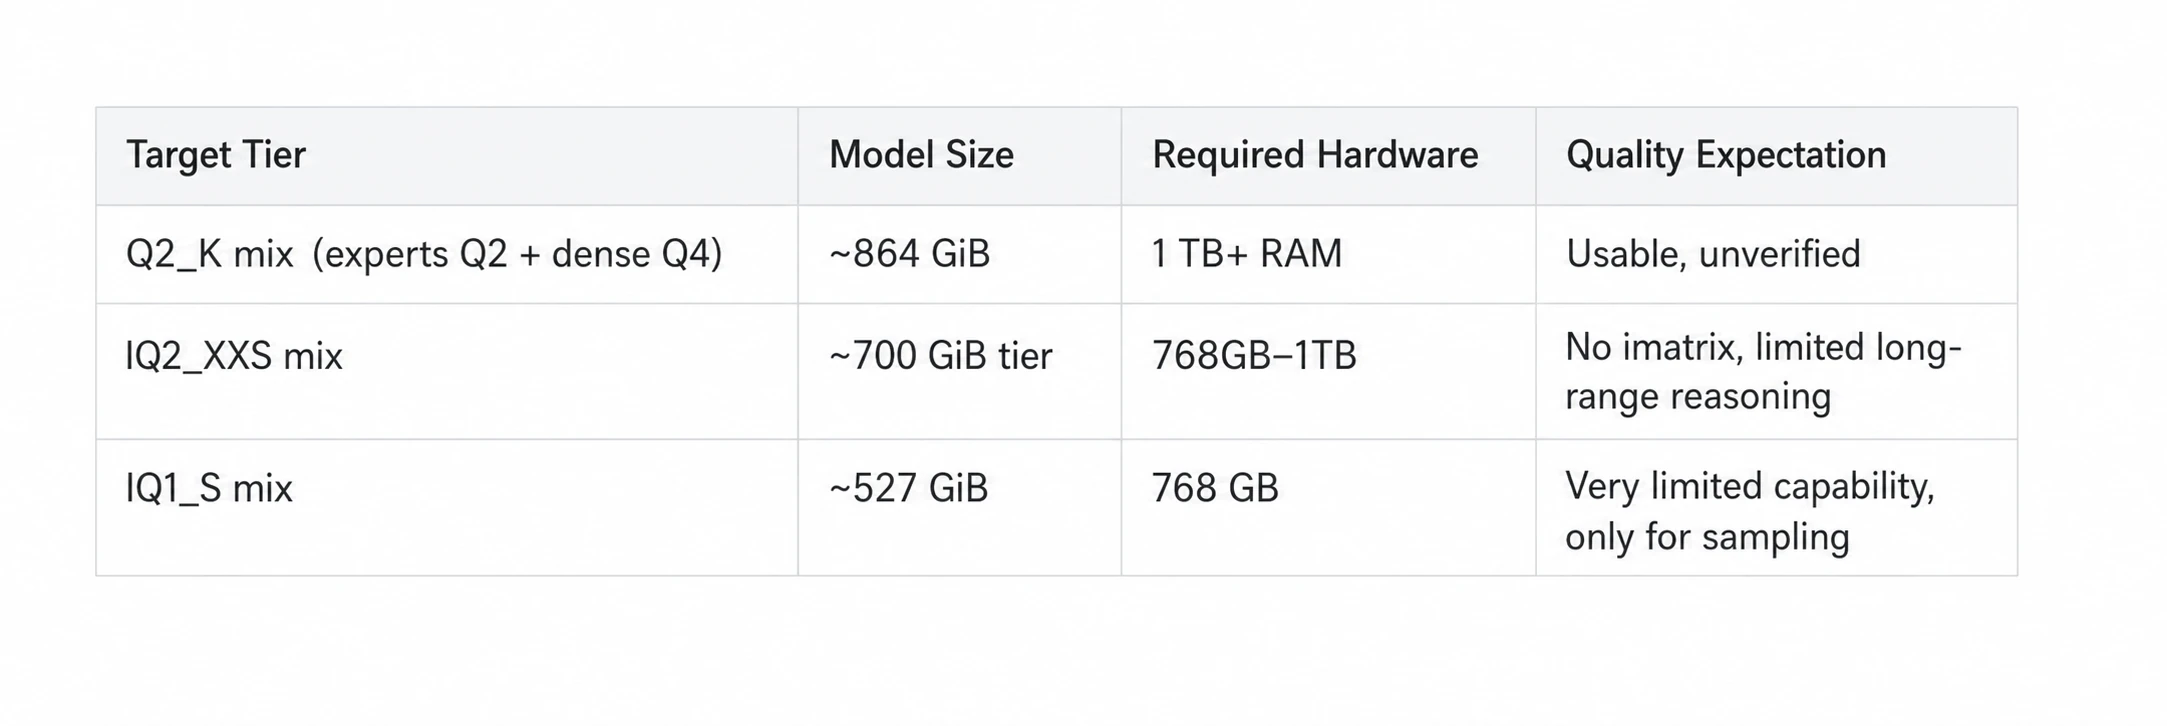
• 768 GB:只够1Q1_S(1.63 bpw 极限量化,质量损失明显,且无 imatrix、砍掉视觉塔)
• 1TB:Q2_K 级勉强(含KV 和系统很紧)
• 1.5-1.7 TB:原生 MXFP4 满血
• 速度推算:K3 每 token 激活104B(K2的3.25 倍),同级机器速度约为K2的 1/3 4-bit级 3-6 tok/s,IQ1_S + GPU offload 乐观 5-10 tok/s。好消息是 KDA 架构让长上下文时 KV 几乎不涨,CPU 方案在长文场景反而相对占优
七、消费级显卡到底行不行?(量化減重专题)
核心结论:不存在任何能把 K3 塞进单张消费级显卡显存的量化方案,物理上不可能。最极端的 1.63 bpw 量化仍有 527 GiB,而消费卡显存是16-32 GB,差着一个数量级还多。
但"消费级显卡参与跑K3"是可能的一—正确的问法是"显卡+多大内存"。可行范式与时间线:
7.1混合卸载(唯一现实路径)
GPU 只放稠密层/注意力/ 共享专家(约 30 GiB@Q4),全部路由专家放系统内存:
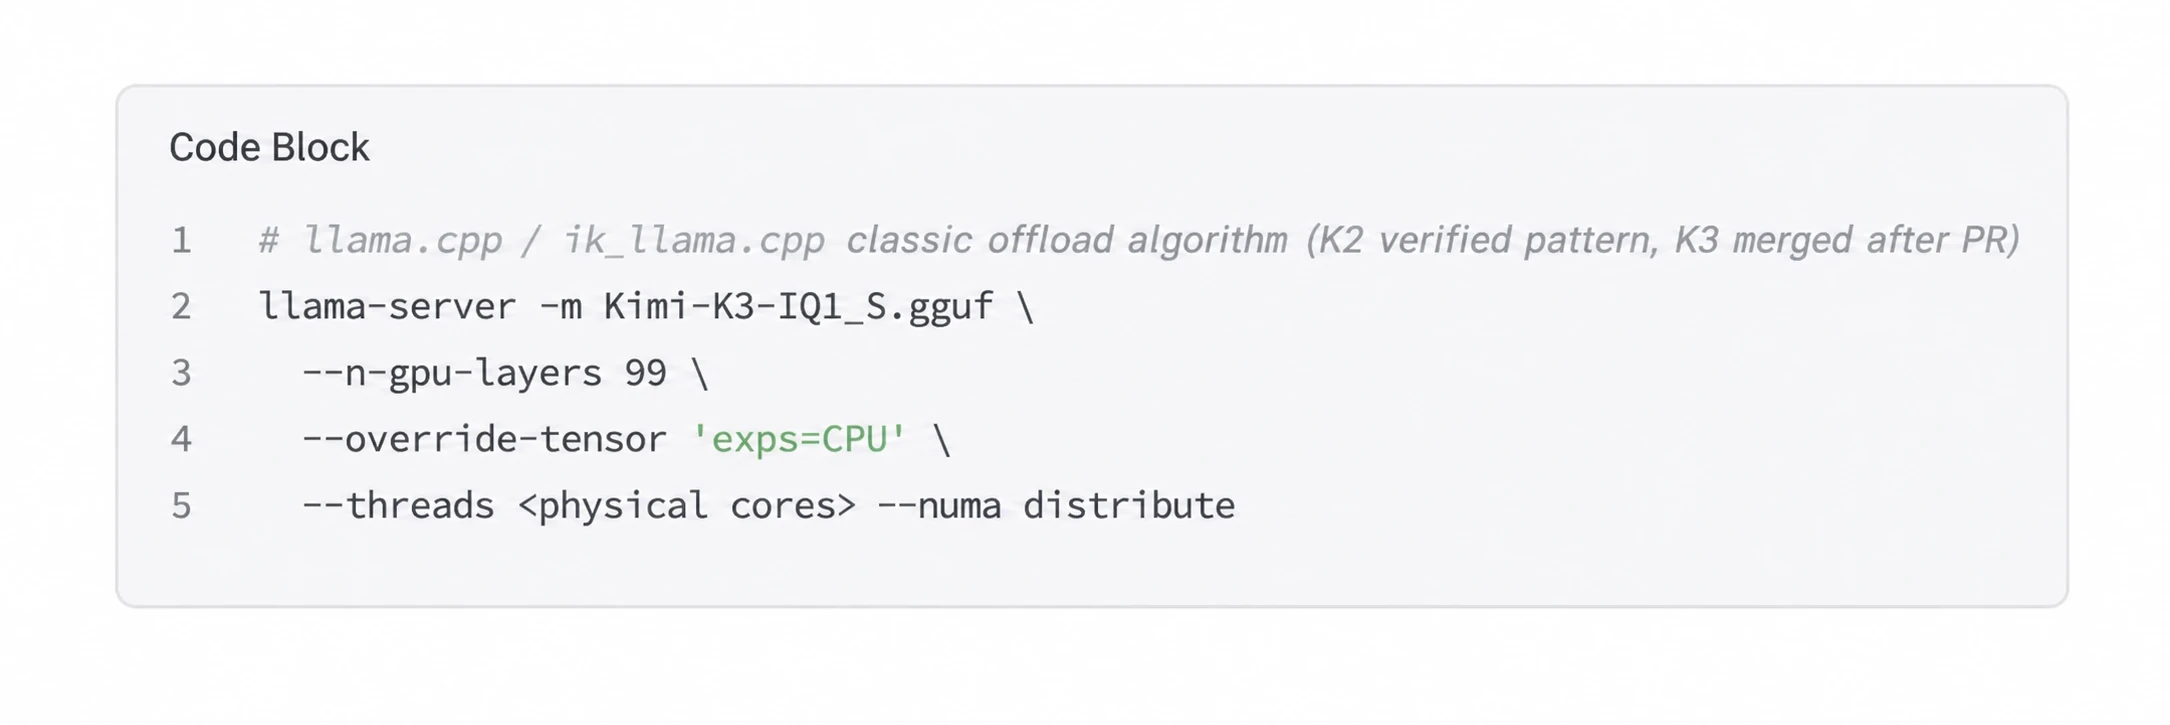
• —张 24GB 卡(4090/5090 级)+768GB服务器内存:1Q1_S能跑,~5-10 tok/s
• 显卡的价值主要在 prefill 提速和 TTFT,decode 瓶颈永远在内存带宽
• 普通桌面平台(双通道 DDR5,上限192-256GB)彻底无缘 K3,必须是 EPYC/Xeon 8-24 通道平台
7.2 unsloth Dynamic 量化(数天~数周内最值得等)
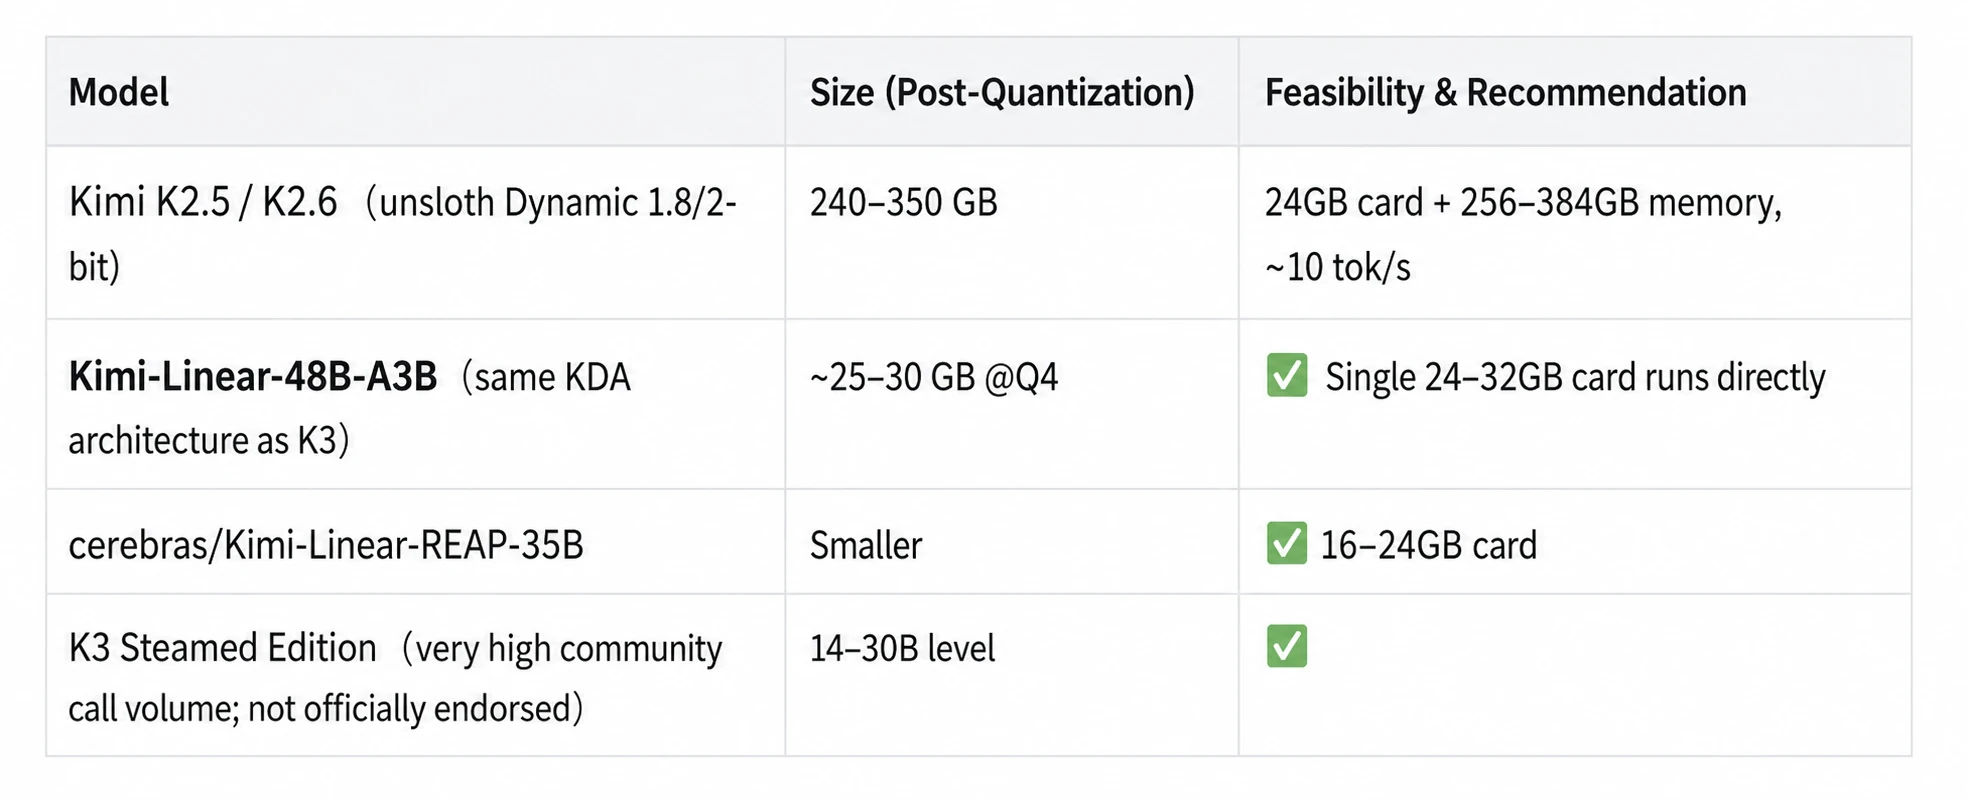
先例数据(同门 K2.5,1T 参数):Dynamic 1.8-bit 压到 240GB(-60%),官方教程实测"单张 24GB卡+ 256GB 内存 ~10 tok/s"。按比例推算K3 的 Dynamic 1.8-bit 约 550-600GB—一注意 K3 出厂已是 4-bit QAT,再压到 2-bit 以下的质量损失会比从 BF16压更难看,unsloth 仓库已建空占位,等他们的校准结果。
7.3 REAP 专家裁剪(真正"减重"的方向,早期但值得
盯)
Cerebras REAP (Router-weighted Expert Activation Pruning)按路由权重+激活范数一次性裁掉冗余专家。K3 有896 个专家但每 token 只用16个一一几余空间巨大:
• Pipe Network 已宣布 MLX 流式转换+ REAP 裁剪,声称把 K3 压到 350GB 跑上 Mac Studio(发布1天,质量未经第三方验证)
•先例: cerebras/Kimi-Linear-REAP-35B-A3B (Kimi-Linear 48B-35B)
•- 社区在讨论 896256/128 专家的裁剪版;针对特定工作负载(如纯代码)校准裁剪,是消费级硬件吃上 K3 的最现实希望
7.4现在就想在消费卡上用 Kimi? 换小兄弟
八、许可证与合规
Kimi K3 License(MIT 改造5条款,已逐条核读):
1. 默认允许商用、修改、分发、微调、销售衍生品
(保留版权声明即可)
2. 新增 Maas 门槛:如果你(含关联公司)经营"模型
即服务"业务(把模型推理/微调开放给第三方,如卖 API),且任意连续 12个月总营收超$2,000万-—必须先与 Moonshot 签商业协议。纯产品内嵌功能、转发第三方托管请求都不算 MaaS
3. 归属展示:产品月活>1 亿 或 月营收 >$2,000万
一界面上须显著展示“Kimi K3"(仅展示义务,不收费)
4. 豁免:纯内部使用(不对第三方开放模型能力)完
全豁免第2、3条
5. 输出内容同样 AS-IS 免责
对绝大多数团队:自部署内用零门槛;做 API 生意且公司年入$2,000万以上才需要找 Moonshot 谈。
中国侧合规:面向公众提供生成式AI 服务需完成 CAC 生成式 AI(大模型)备案;纯内部部署不需要。
九、不想碰硬件?API 兜底价
官方:platform.kimi.ai, OpenAI/Anthropic 双兼容协议
国内一方渠道:阿里云百炼已上架 kimi-k3(已核实):输入 ¥20/百万 token(缓存命中 ¥2)、输出¥100/百万 token,1M 上下文
换算:$3-7.3 万/月的16×H200 租金~每月2,000万~5,000万输出 token 的API用量。日均输出低于100 万 token 就老老实实用 API
比起租 GPU,更愿意直接采购结果的团队,可以把这套部署当成一单需求,发到任务市场上。
十、行动建议(按预算分档)
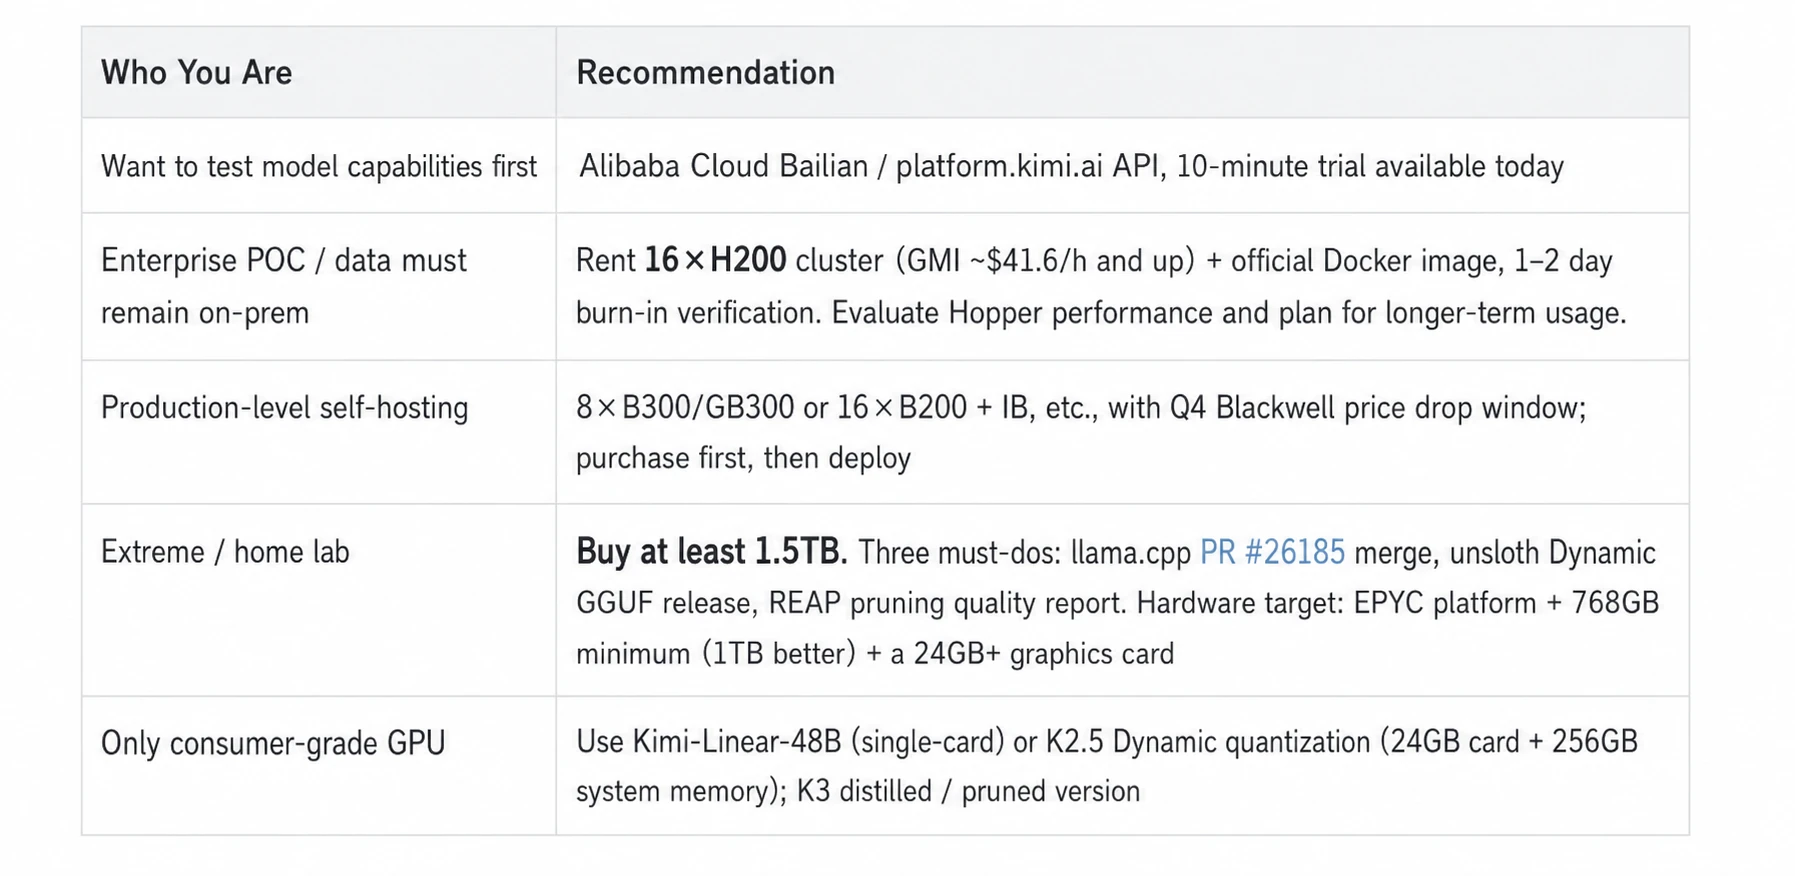
给所有人的提醒:模型发布刚1天,官方 recipe 24 小时内改了 3版,所有第三方量化都未验证质量。除 API 外的任何花钱决定,都值得再等1-2周让生态稳定。
十一、部署后的并发与吞吐规划
承接第三、四节:机器点亮只是起点,这一节回答「这套集群到底能同时服务多少人、每人多快」。
11.1 决定并发能力的三个因素
K3 的服务容量由三件事共同决定,缺一不可:
1. Prefill 算力:每token 激活 104B 参数,长 prompt
的首 token 延迟(TTFT)是算力瓶颈一—这也是 H20 这类「显存够、算力弱」的卡最痛的地方;
2. Decode 内存带宽:生成阶段每个 token 都要把激
活参数读一遍,batch 越大总吞吐越高、但单用户 tok/s 越低;
3. KV/状态显存预算:装完权重后剩下的显存,决定能
同时挂多少条序列。
11.2 每个并发用户占多少显存(K3 独有的好消息)
K3 的 KDA 混合架构让并发账本跟传统大模型完全不同一—93 层里只有24层 MLA产生随上下文增长的 KV,69 层 KDA 是每序列固定 ~127MB 的循环状态:
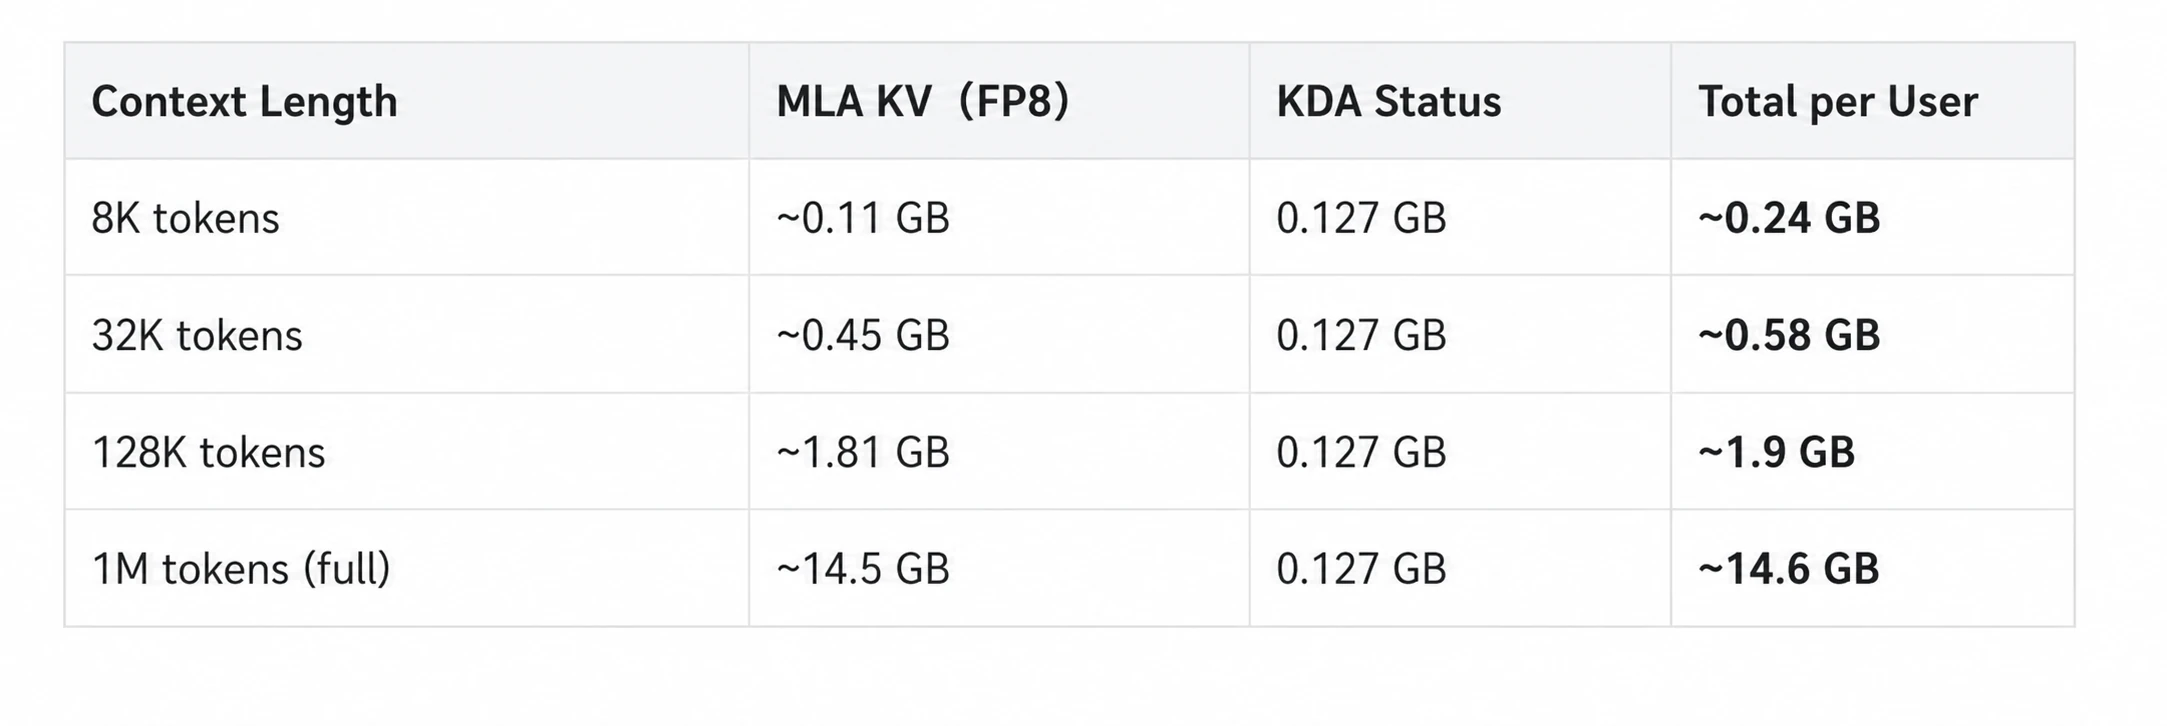
对比传统全注意力 2.8T模型,K3的 KV 增长慢约 29 倍一一长上下文并发是K3 的强项;反过来,短上下文高并发时 KDA 那127MB 固定成本占大头(1000并发=127GB 纯状态)。
11.3各配置并发容量估算(显存上限口径)
按「装完权重后的余量- 每卡~15GB 激活/CUDA 图/通信缓冲」估算可用KV 预算:
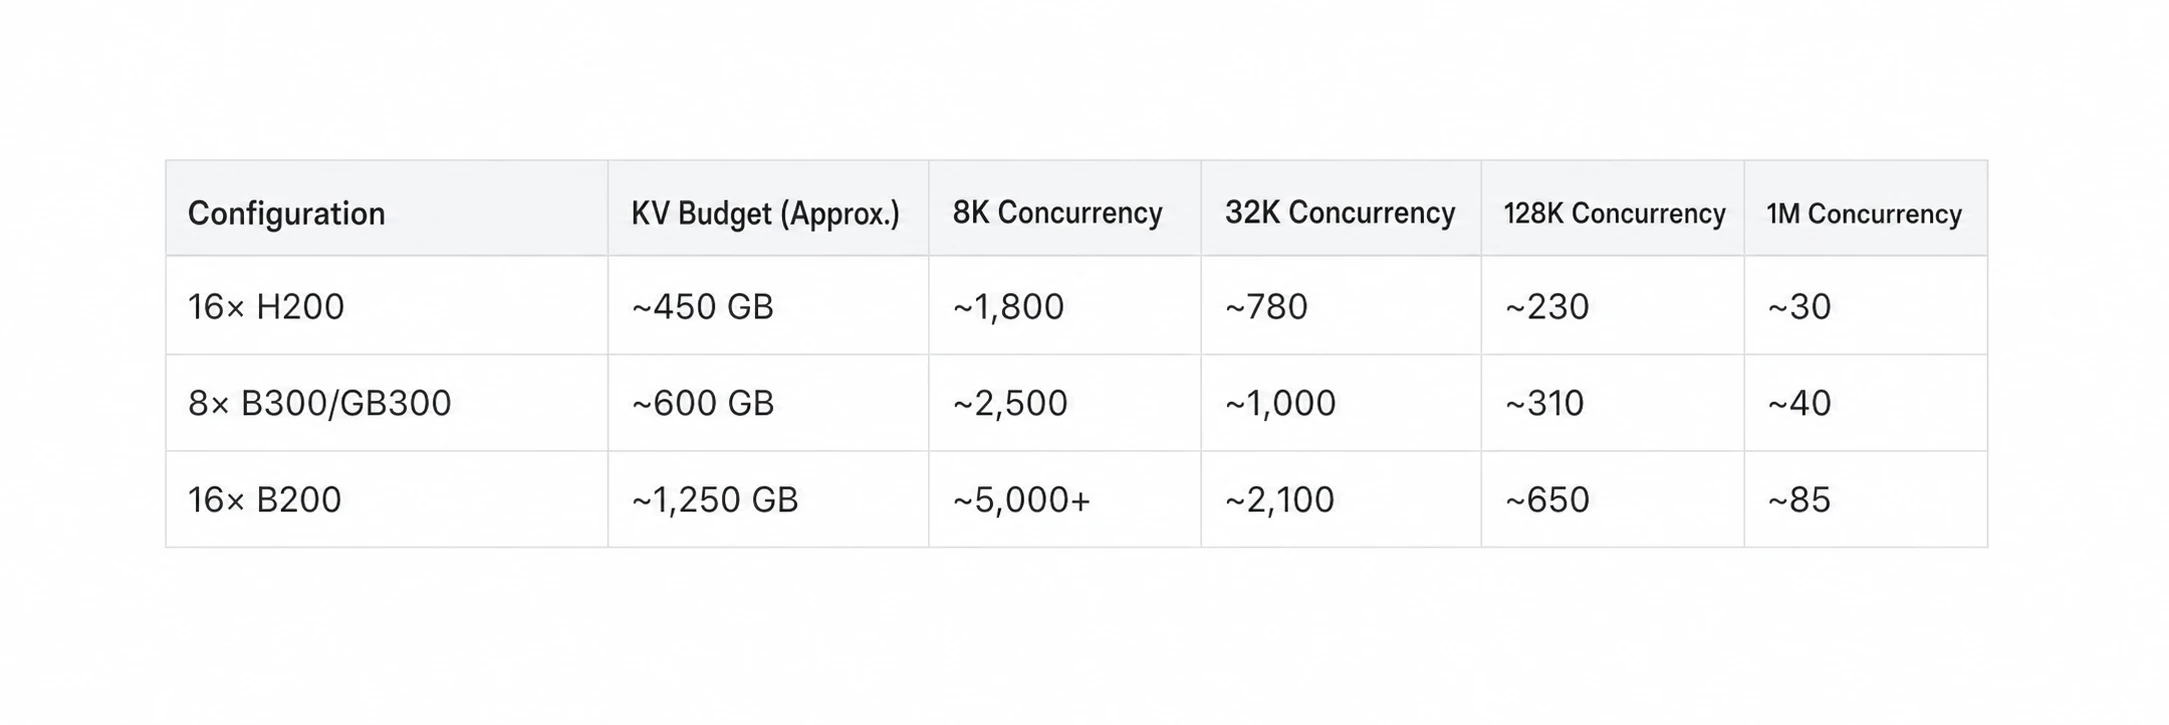
三个必须理解的修正:
• 这是显存能挂住的上限,不是服务质量线—一实际并发到几百时,decode 总带宽被分摊,单用户速度会先于显存耗尽掉到不可接受;官方多节点基准用的是--max-num-seqs 512,可视为官方认可的实用并发量级;
• 官方单用户实测(Blackwell):TP8 = 111 tok/s、TP16 = 118 tok/s;开 DSpark 投机解码后 331/370 tok/s—一但投机解码强制 --max-num-seqs
• Hopper(16xH200)没有任何公开吞吐数据,上表对它只保显存口径成立,性能必须自己压测。
11.4 按业务场景调参
在线聊天服务(8-32K 上下文,要求单用户 >30 tok/s):从--max-num-seqs 128 起步压测,逐步加到延迟不可接受內止;--kv-cache-dtype fp8 必开(KV减半)。
Agent / 编码工作负载(长上下文+多轮工具调用): K3 的 prefix caching 默认是关的(混合缓存设计仍在演进),必须显式加--enable-prefix-caching,否则每轮工具调用都全量重算 prompt,TTFT 会灾难性上升;多轮对话记得原样回传 reasoning_content。
高并发生产(数百 QPS):用官方已验证的 P/D 分离
一-TEP8 做 prefill(--max-num-batched-tokens 16384)+ DEP16 做 decode,把「算力型」和「带宽型」负载拆开独立扩容;这需要3 节点起步(1 prefill +2 decode 为最小实验形态)。
离线批处理:拉满 batch、关投机解码、--language-model-only(纯文本任务跳过视觉编码器再省一块显存),吞吐优先。
11.5 上线前压测(官方 harness)
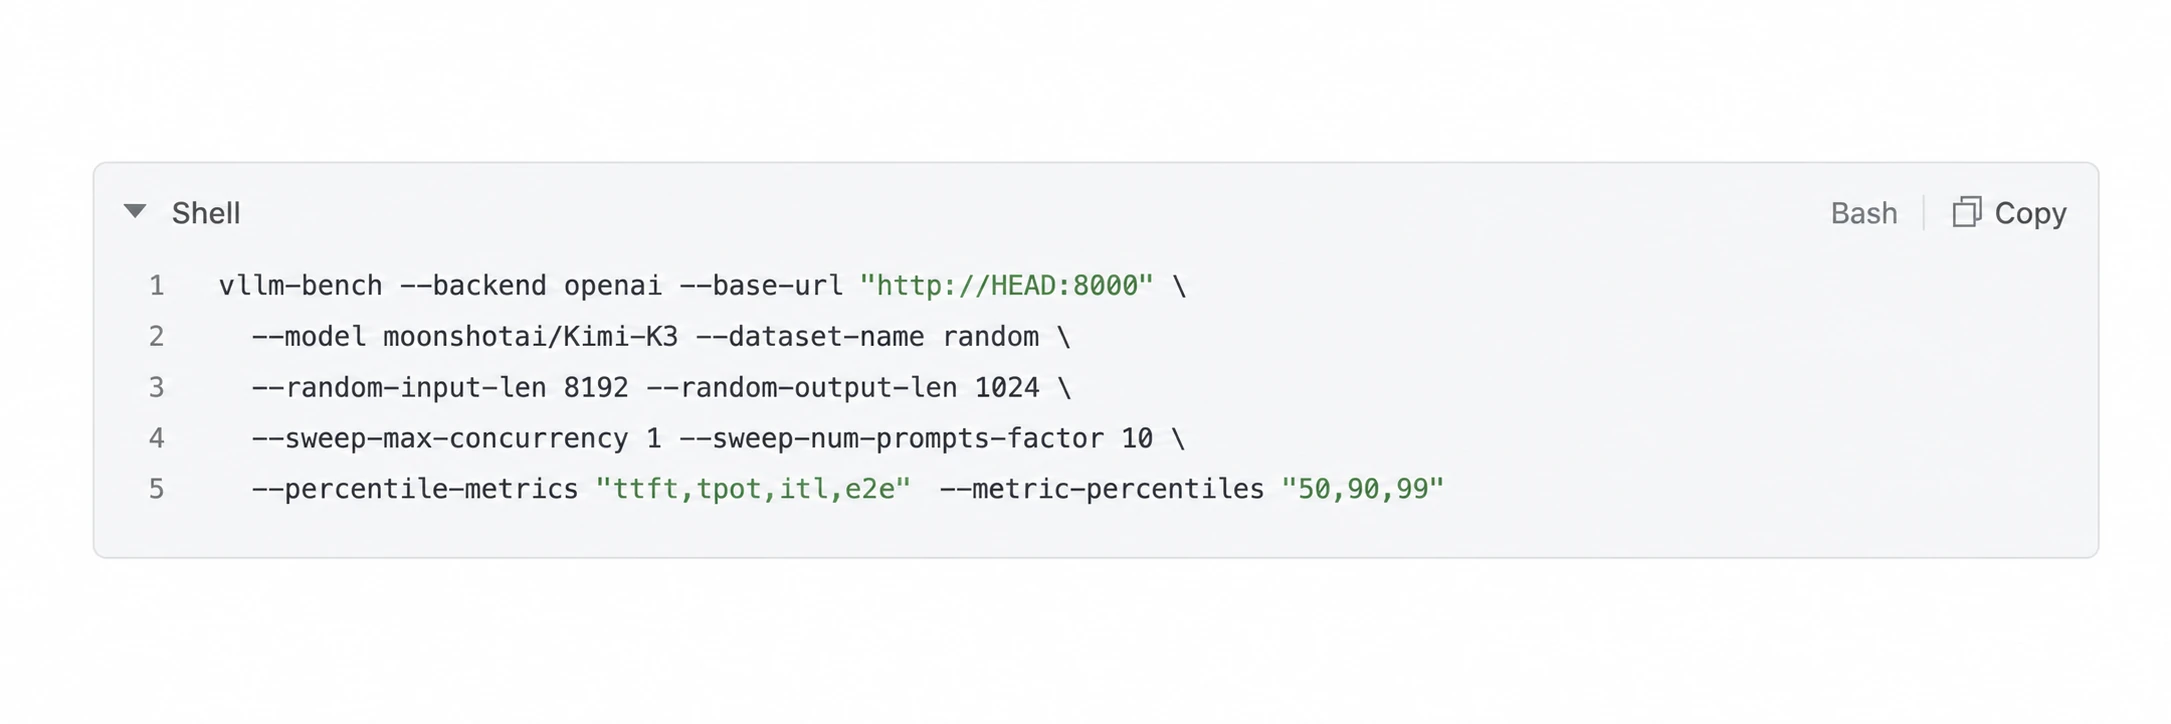
把--sweep-max-concurrency 按 1 32 128 512 扫一遍,盯 P90 TTFT(进场体验)和 P50 TPOT(生成速度)两条曲线,拐点就是这套硬件的真实并发容量。预算 1-2天租金做 burn-in,比拍脑袋定容量便宜得多。
十二、量化落地实操手册(自己动手版)
承接第六、七节:那里讲了「生态现状」,这里给出「自己动手」的完整操作路径。先记住总原则:出厂 MXFP4 已经是 4-bit 满血,自制量化只有两个正当目的一-①压得更小(1-2bit,塞进更小内存);②裁得更小(REAP,真正减参数)。
12.1 路线 A:GGUF 转换+低比特量化
(Ilama.cpp)
硬件门槛(转换本身不需要 GPU):
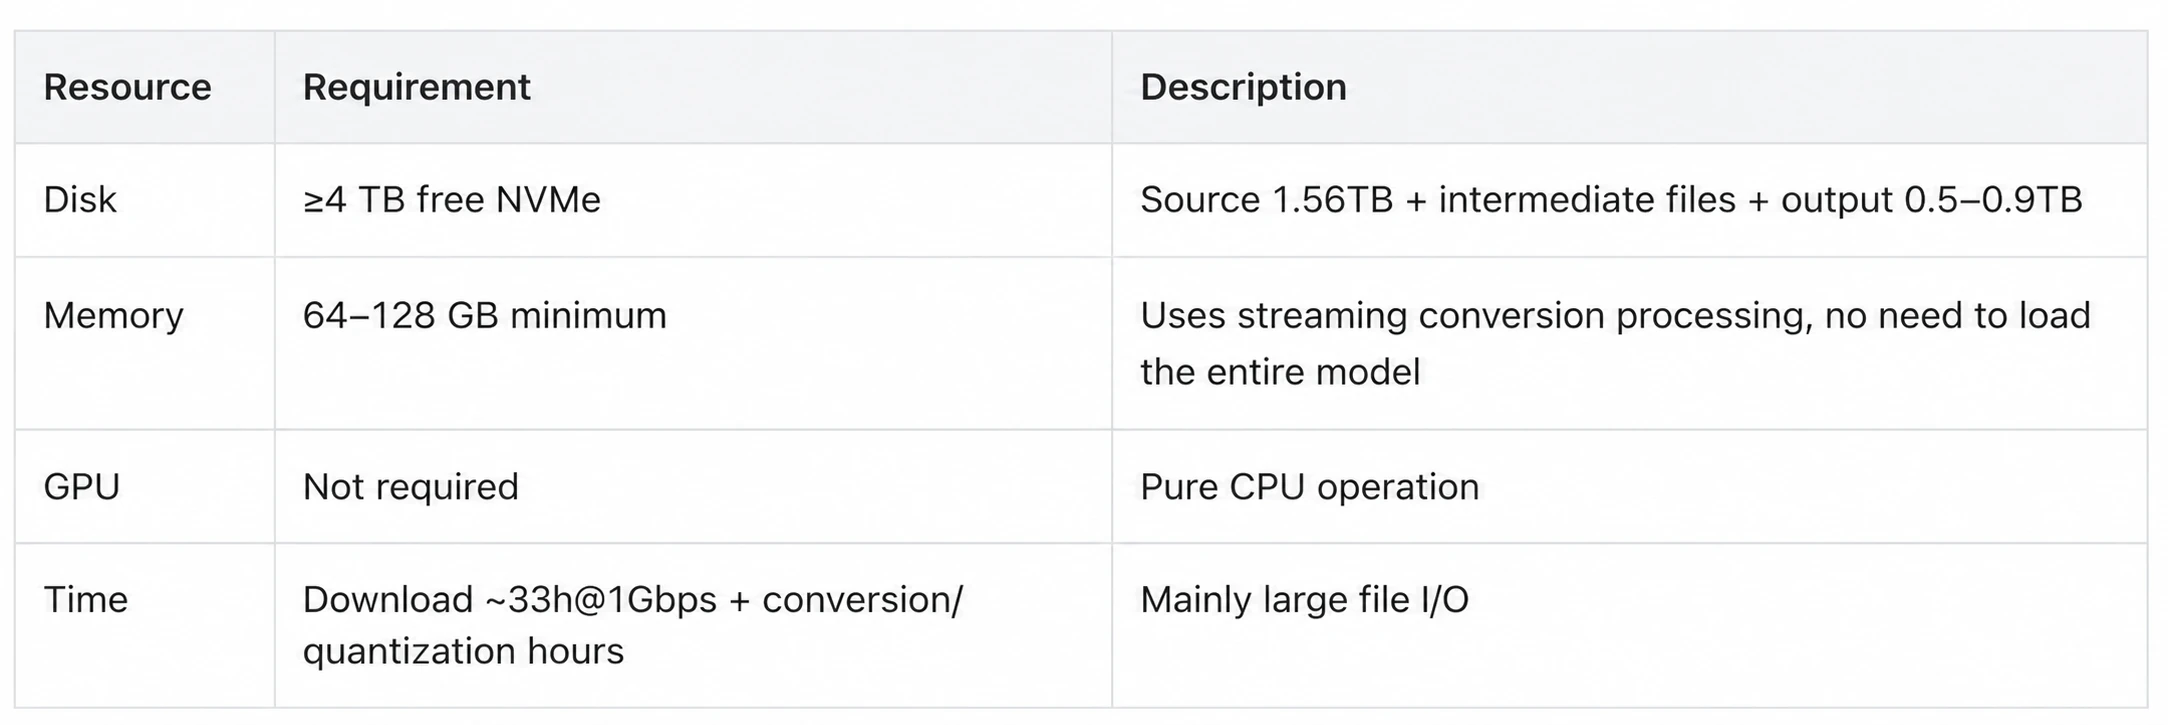
操作步骤:
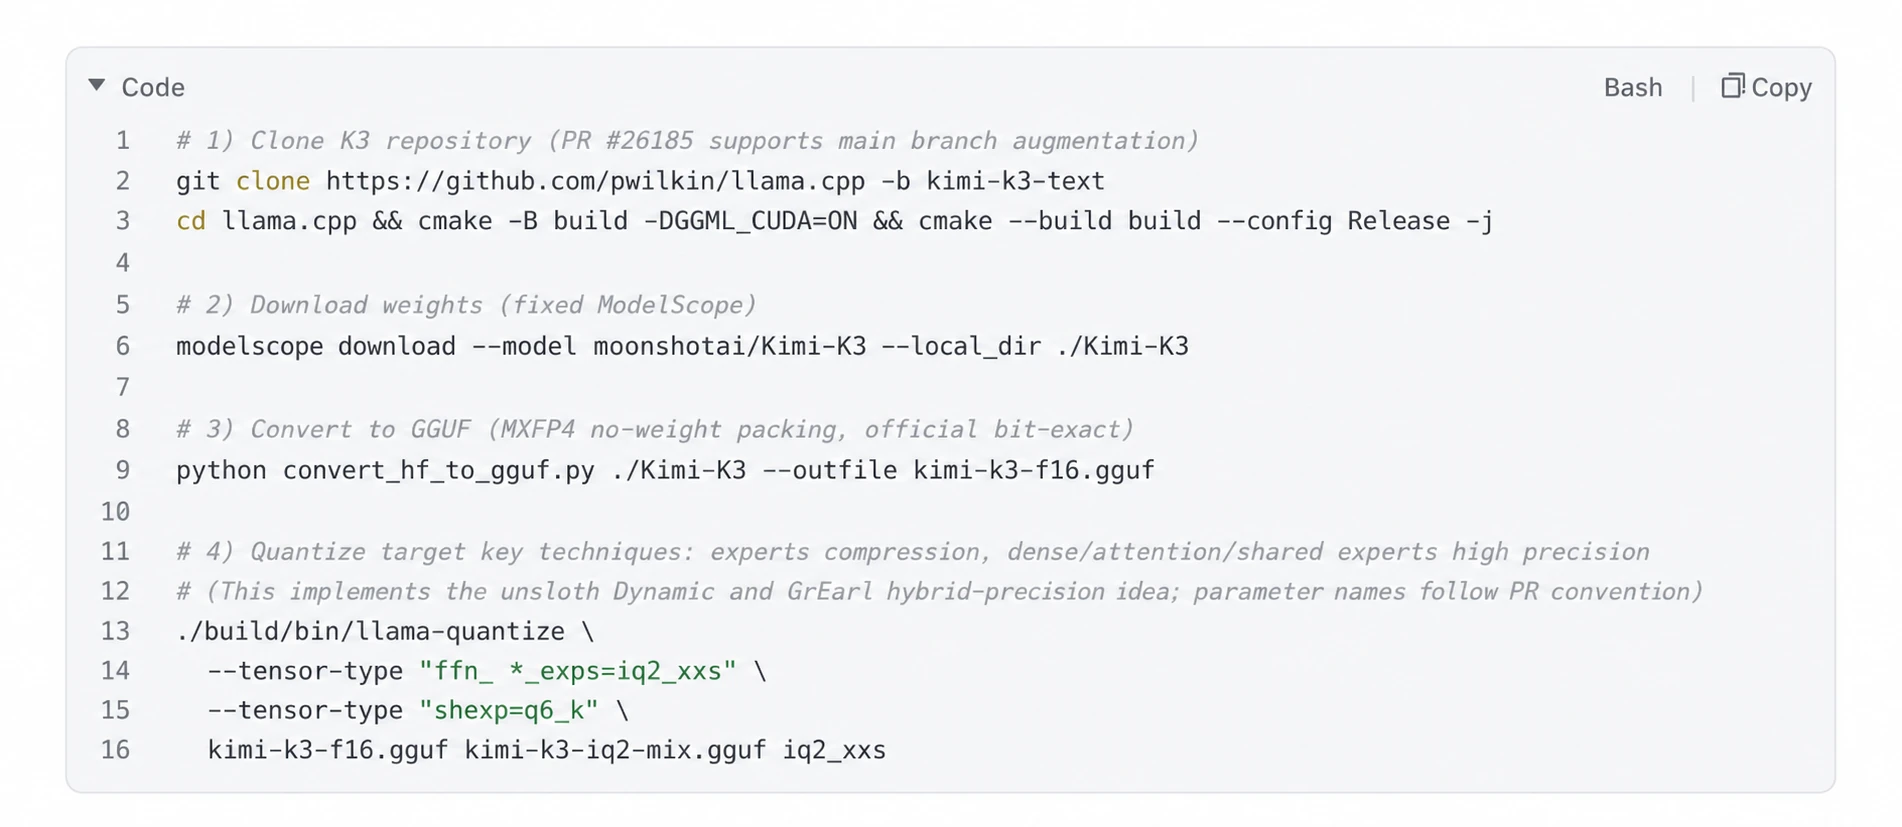
档位怎么选(对照自己的内存):
imatrix一—质量的分水岭(也是 DIY 的真正大坎): 2bit 以下量化不带 importance matrix 基本必降智。做 imatrix 需要把模型真的跑起来在几百万 token 校准语料上做前向统计:
口复制
这一步要 768GB+内存的机器跑数小时到数天一一这正是个人做不过 unsloth 的原因(他们有校准集群和调好的校准集)。没有这台机器的替代方案:直接等社区带 imatrix 的版本,或租一台大内存云主机跑一次(几百块钱,比买硬件划算)。
量化完必做验证:Ilama-perplexity 跑 wikitext +拿自己业务的 20-50 条真实 prompt 与 API 版对答(第九节的百炼 API就是现成的基准对照)。
12.2路线 B:复刻 unsloth Dynamic(不建议,理解
思路即可)
unsloth Dynamic 的三件套= 层级敏感度分析+逐层动态位宽+自家校准集。前两件可以用 12.1 的-tensor-type 覆盖近似(敏感层保Q6-Q8、不敏感 experts 压 1.5-2bit),第三件(校准集质量)是它的护城河,复刻性价比极低。结论:思路拿来用(混合档位),成品等官方。
12.3 路线 C:REAP 专家裁剪(最值得投入的 DIY,
真正「減重」)
量化是「同样的参数存得更小」,REAP 是「直接删掉你用不到的专家」——K3 的896 个专家每 token 只激活16个,针对特定业务负载裁剪是收益最大的方向:
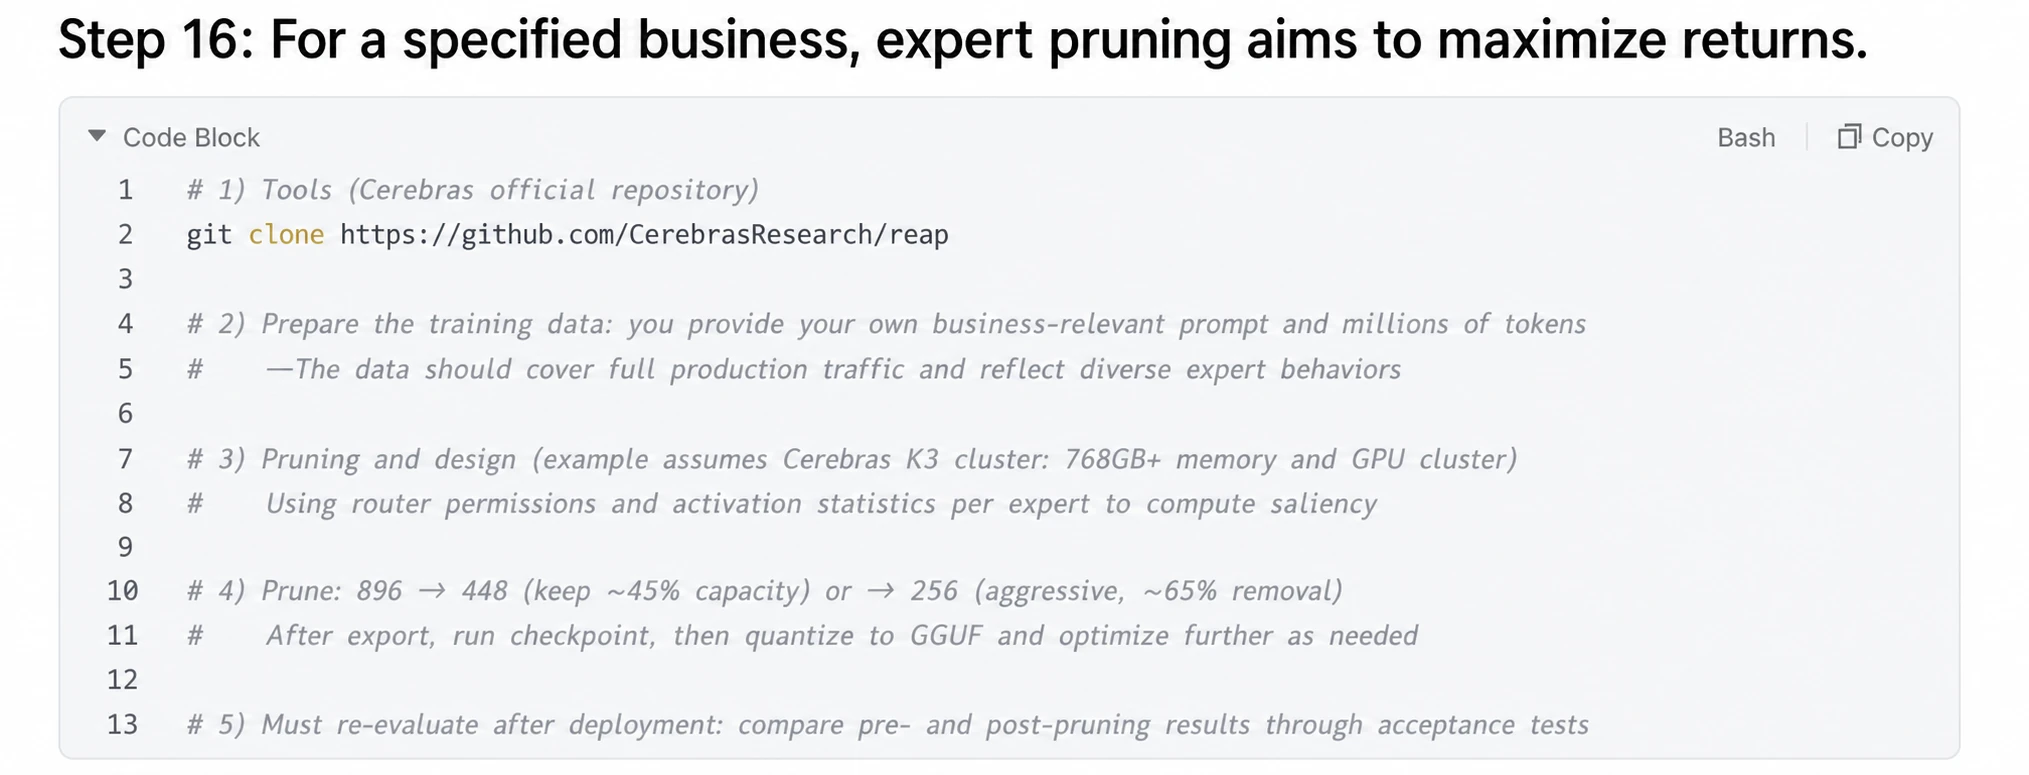
参考坐标:社区(Pipe Network)声称 REAP 能把 K3 压到 350GB 上 Mac Studio(未经第三方验证);Cerebras 官方给 Kimi-Linear 做过 48B-35B 的先例。注意裁剪版是「偏科版」一一按代码语料裁的模型,数学和多语言能力会明显缩水,通用场景慎用。
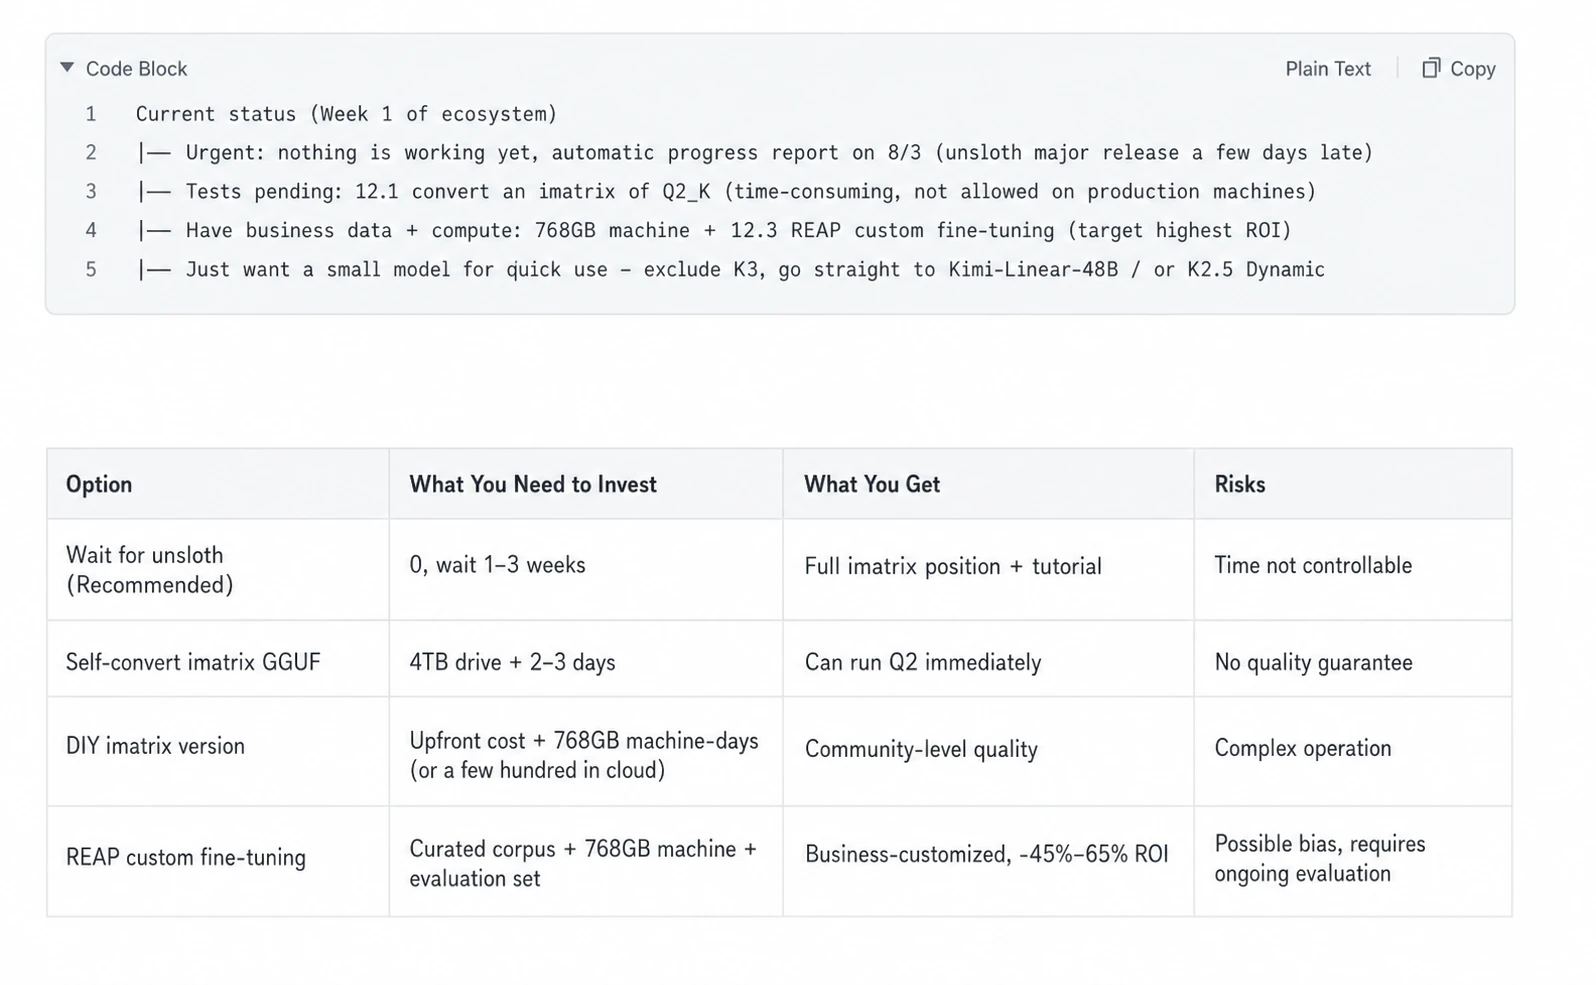
12.4 決策树+成本对照
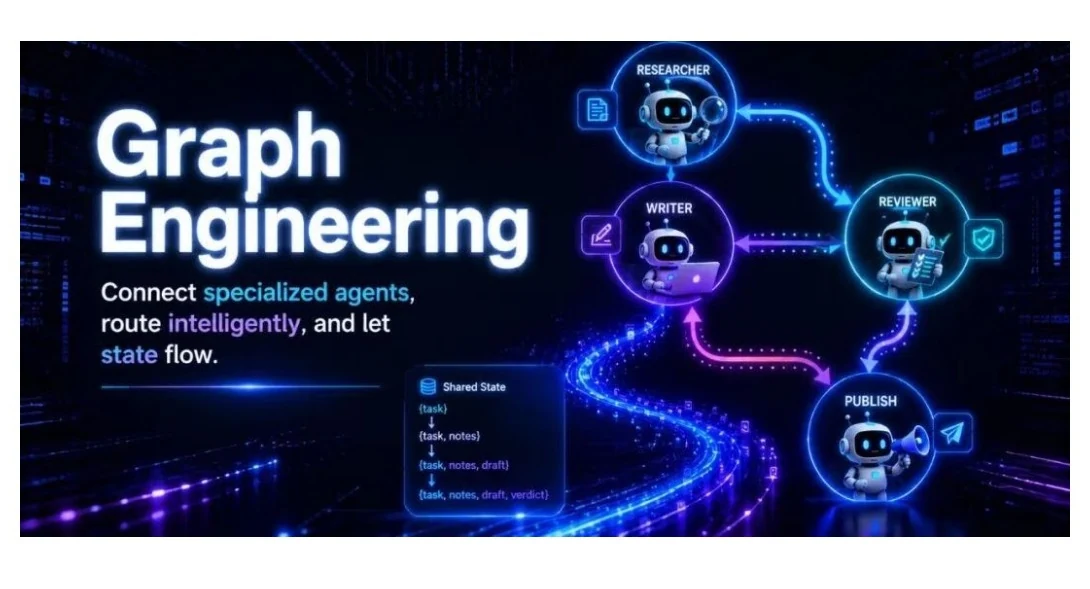
模型跑起来之后,下一个架构问题是怎么把多个模型编排成一张图——Graph Engineering 的定义与由来,我们另开了一篇。
如果想了解更多ai热点,欢迎关注公众号,或访问访
问 clawhunt.store。
附录:核心来源
模型与权車:HuggingFace 模型卡•config.json• LICENSE• ModelScope 镜像•技术报告 PDF
官方部署:VLLM Recipe•VLLM day-O 博客•SGLang Cookbook • TokenSpeed
价格(2026-07:28当日核买):Core Weave•Lambda, RunPod•GMI Cloud• Vast.ai
API: 阿里云百炼 kimi-k3
本文由 10 路并行研究代理 +2路对抗核查生成,所有关键数字(权重体积、显存裁决、租价)均经第二来源交叉验证;标注"推算/未验证"的数字请以后续实测为准。