老波|ClawHunt-爪寻AI · 2026年8月3日 18:05 · 广东
很多品牌还在研究怎么让用户搜到自己。
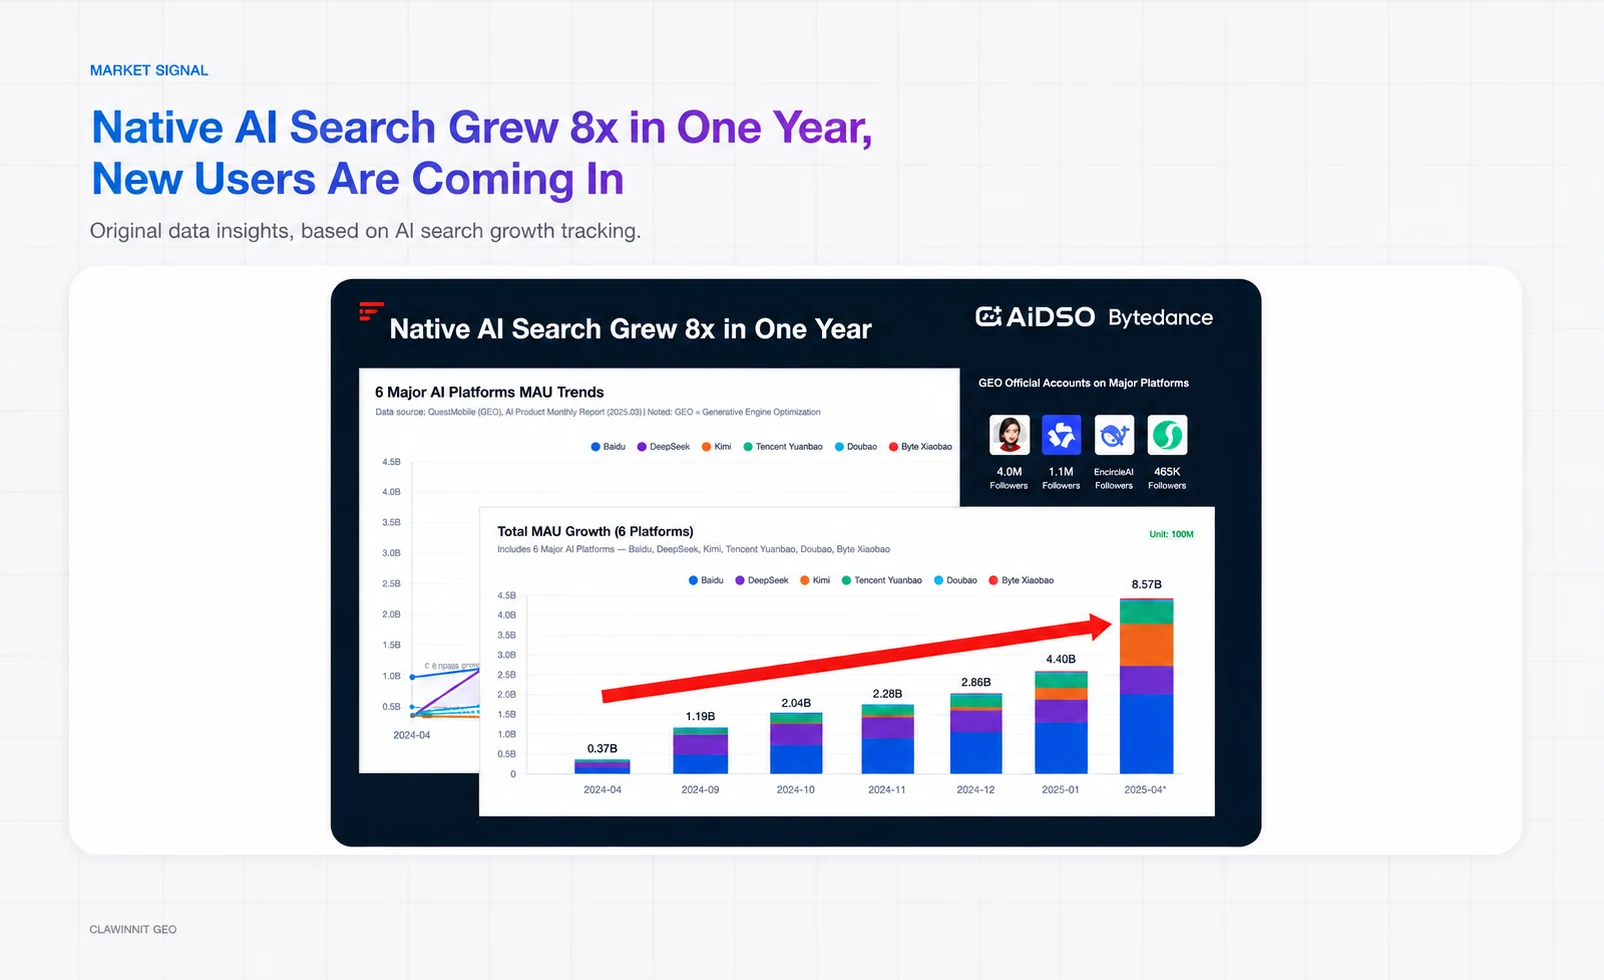
用户已经换了一个动作:打开豆包、千问、DeepSeek,直接问一句,“这个品类到底怎么选?”
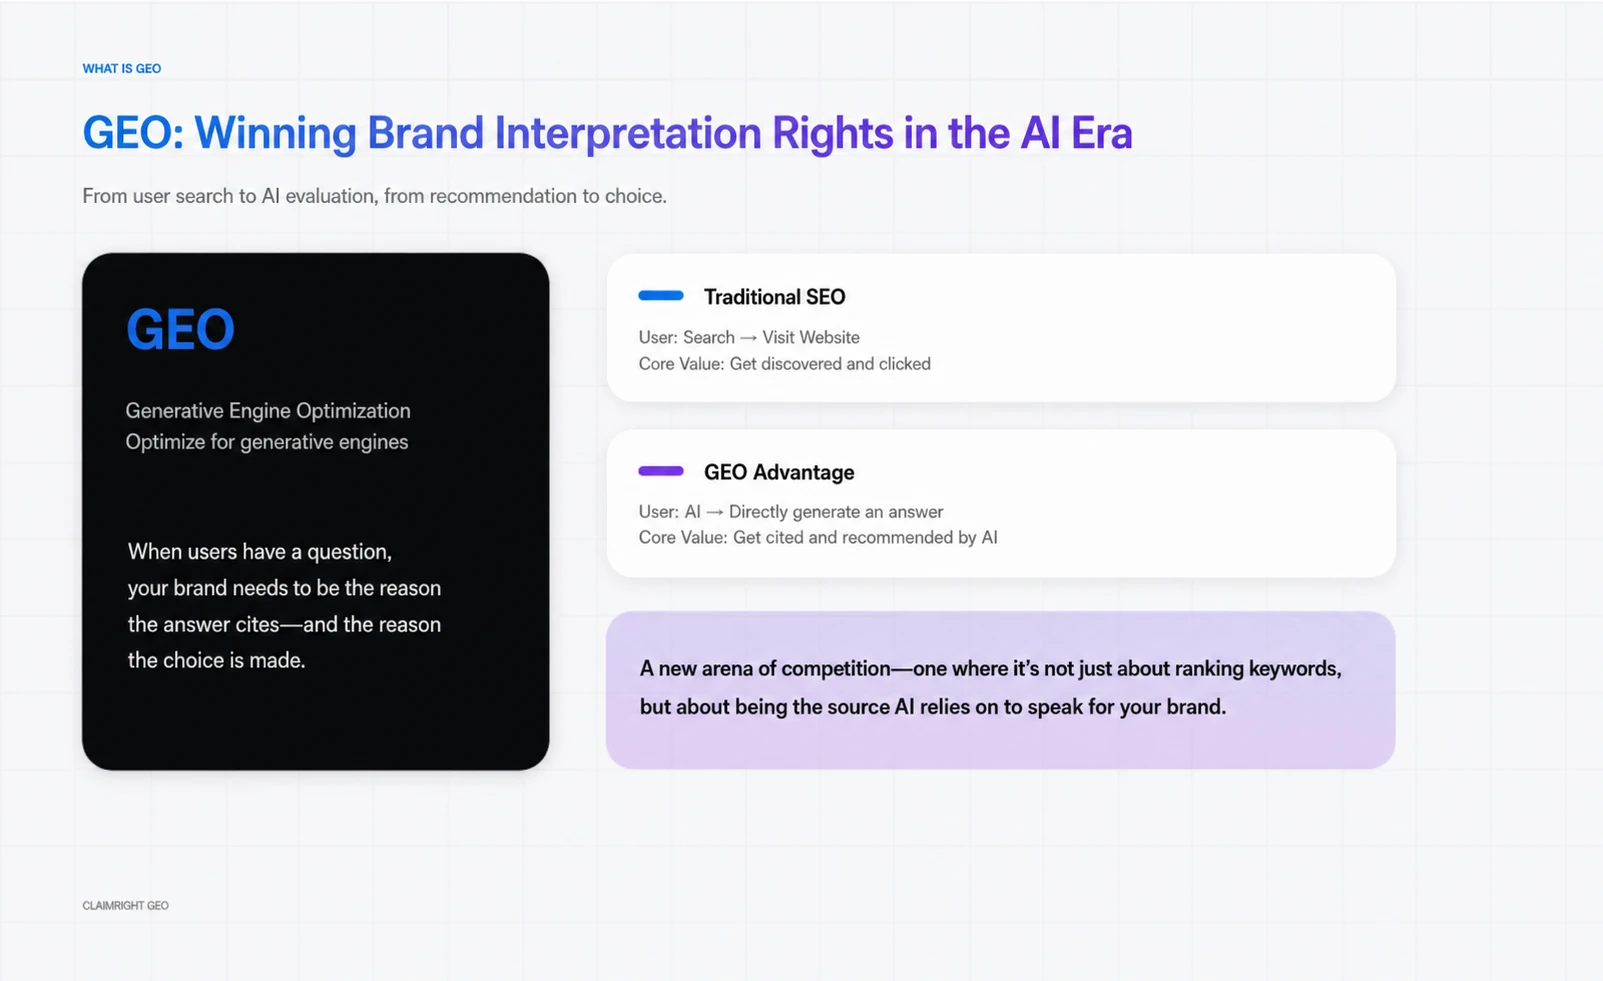
这意味着品牌的解释权正在被重新分配。
接下来发生生的事很像有个新同事替用户把会议纪要写完了。他会汇总资料、列出候选、解释差异,偶尔还会替用户下一个判断。区别在于,这位同事不在你的公司,也不看你的周报。
它叫 AI。
过去,搜索结果页像一条商业街。品牌争的是门头、位置和进店率。现在,AI 把用户带进了一间咨询室:用户说出困惑,AI 给出几种路径,顺手把几个品牌放进答案里。
这个场景里,品牌的名字有没有出现,出现时带着什么理由,引用了什么内容,已经开始影响用户的第一层信任。
更麻烦的是,许多团队还不知道自己在 AI 里长什么样。
官网写得很完整,公众号发得很勤,短视频也没有停。可用户问“哪个牌子更适合新手”“这个问题应该找谁解决”“预算有限怎么选”时,AI可能压根没有提到你。也可能提到了,只是和 8个同行一起排在一段很客气的名单里。
那种感觉,有点像你被拉进一个群,却没人告诉你群里在聊什么。
ClawHunt GEO想做的,就是把这件事看清楚。
这篇讲的是方法,真要落到项目上,入口是 ClawHunt GEO 服务页。
Part 1| 用户没有离开搜索,他们把搜索说成了一
句话
人们一直在找答案。以前输入的是关键词,现在输入的是完整问题。以前会搜“降噪耳机推荐”,现在更像在问:“通勤2小时、耳朵容易痛、预算1,000元,哪一款合适?”
关键词更像一个路牌,场景则是一条路线。信息量变大了,品牌也更早进入用户的选择过程。
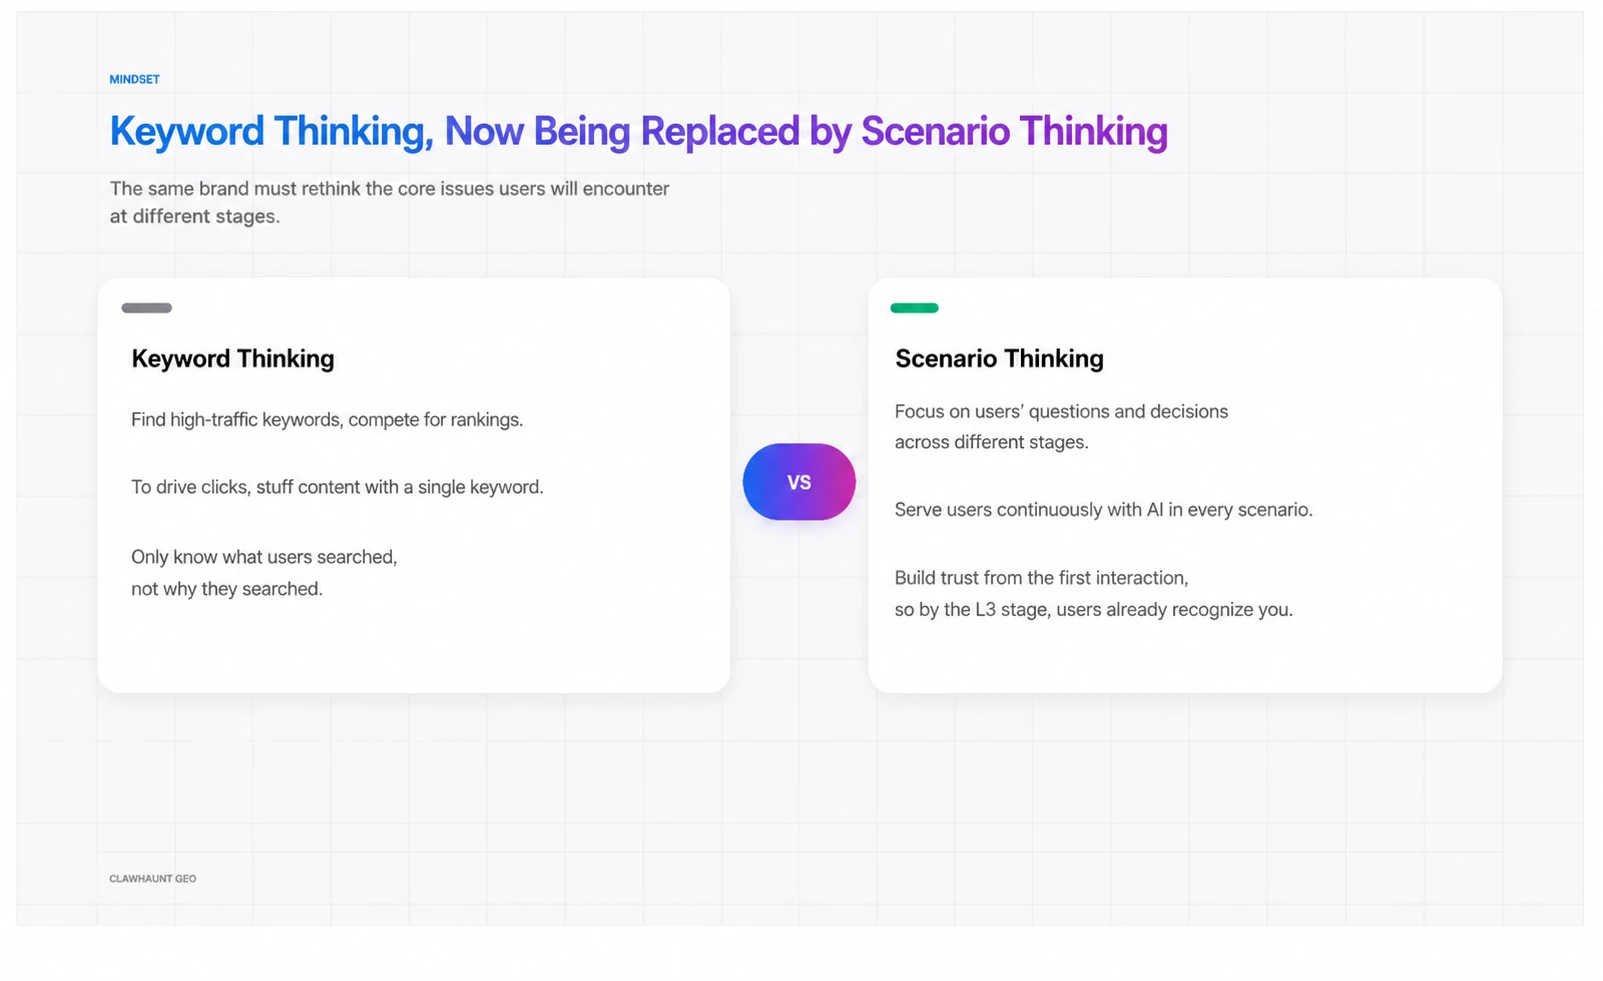
这类变化在高决策成本行业尤其明显,买一个服务、选一个机构、挑一套方案,用户往往会经历连续的五六轮提问:先判断有没有必要,再理解方案,再比较选项,最后才去看价格、预约和成交细节。
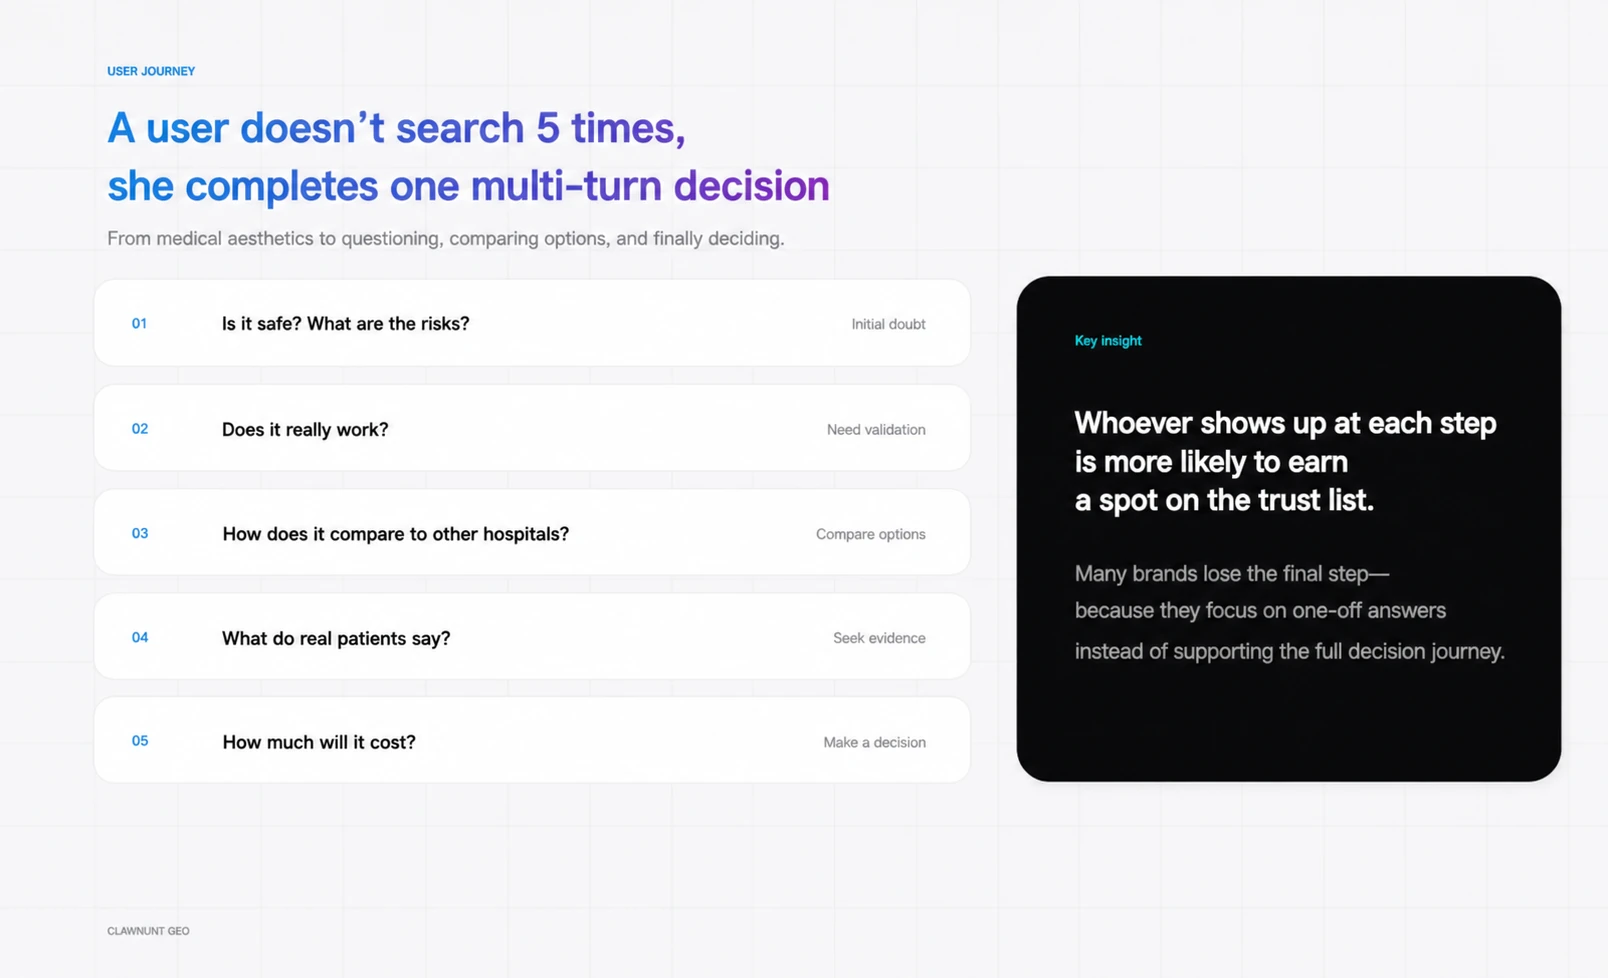
很多品牌都把主要精力放在最后一环:价格页、案例页、咨询入口、销售话术都准备得很充分。问题是,用户在前面几轮已经完成了大量认知工作。她在哪篇科普里理解风险,在谁的对比内容里形成标准,又是在哪个真实案例里觉得“这个人好像和我一样”,这些都在悄悄决定后面的选择。
AI 正在把这段路收得更短。
它会把分散的资料揉成一段看上去很完整的回答。用户未必会逐个打开链接,甚至未必会意识到自己刚刚接受了一次品牌筛选。她只会觉得:这个答案还挺懂我。
品牌需要更早进入这段对话。真实的用户问题、清晰的专业解释、可核验的案例和持续更新的内容,本来就是答案的一部分。AI 只是把这些答案重新排列了一次。
用户现在怎么把需求说出口,更多旁证散落在我们那些来自 Agent 经济的一线信号里。
Part 2| AI 的答案没有统一口径,品牌先别急着截一张图开庆功会
假设用户问:“这个问题应该选哪一家?”回答里列了 A、B、C、D、E。
你的品牌在C位。看起来不错,截图也挺好看,转给老板时甚至可以配一个“重大突破”。
但用户接下来会继续问:为什么?
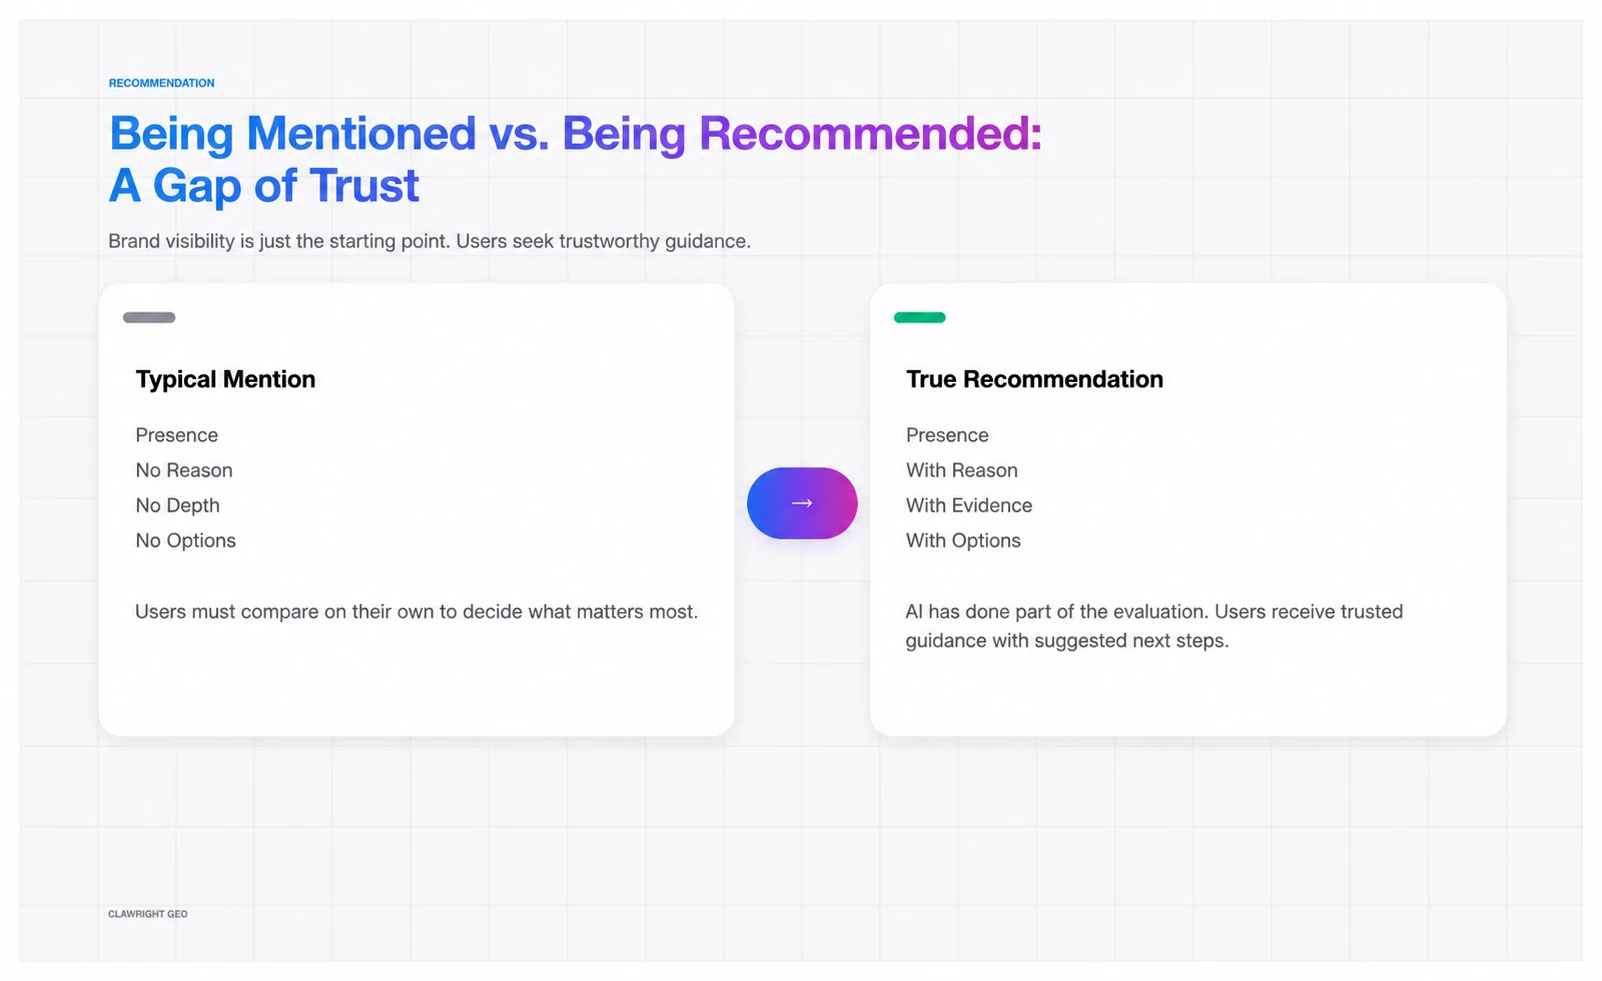
如果 AI给不出理由,品牌名只是一个待比较的选项。用户仍然要去翻资料、看评价、问朋友、打开更多页面。对品牌来说,这意味着注意力刚刚被分发,还没有变成信任。
它会说清楚适用场景,例如适合什么预算、什么需求、什么人群。它会给出选择理由,例如产品能力、服务方式、案例特征或专业边界。它还会留下可以被验证的依据,让用户知道这个判断并非凭空冒出来。
这就是“被提到”和“被推荐”的区别。
前者解决存在感,后者才进入决策感。
有一个特别值得警惕的观察:
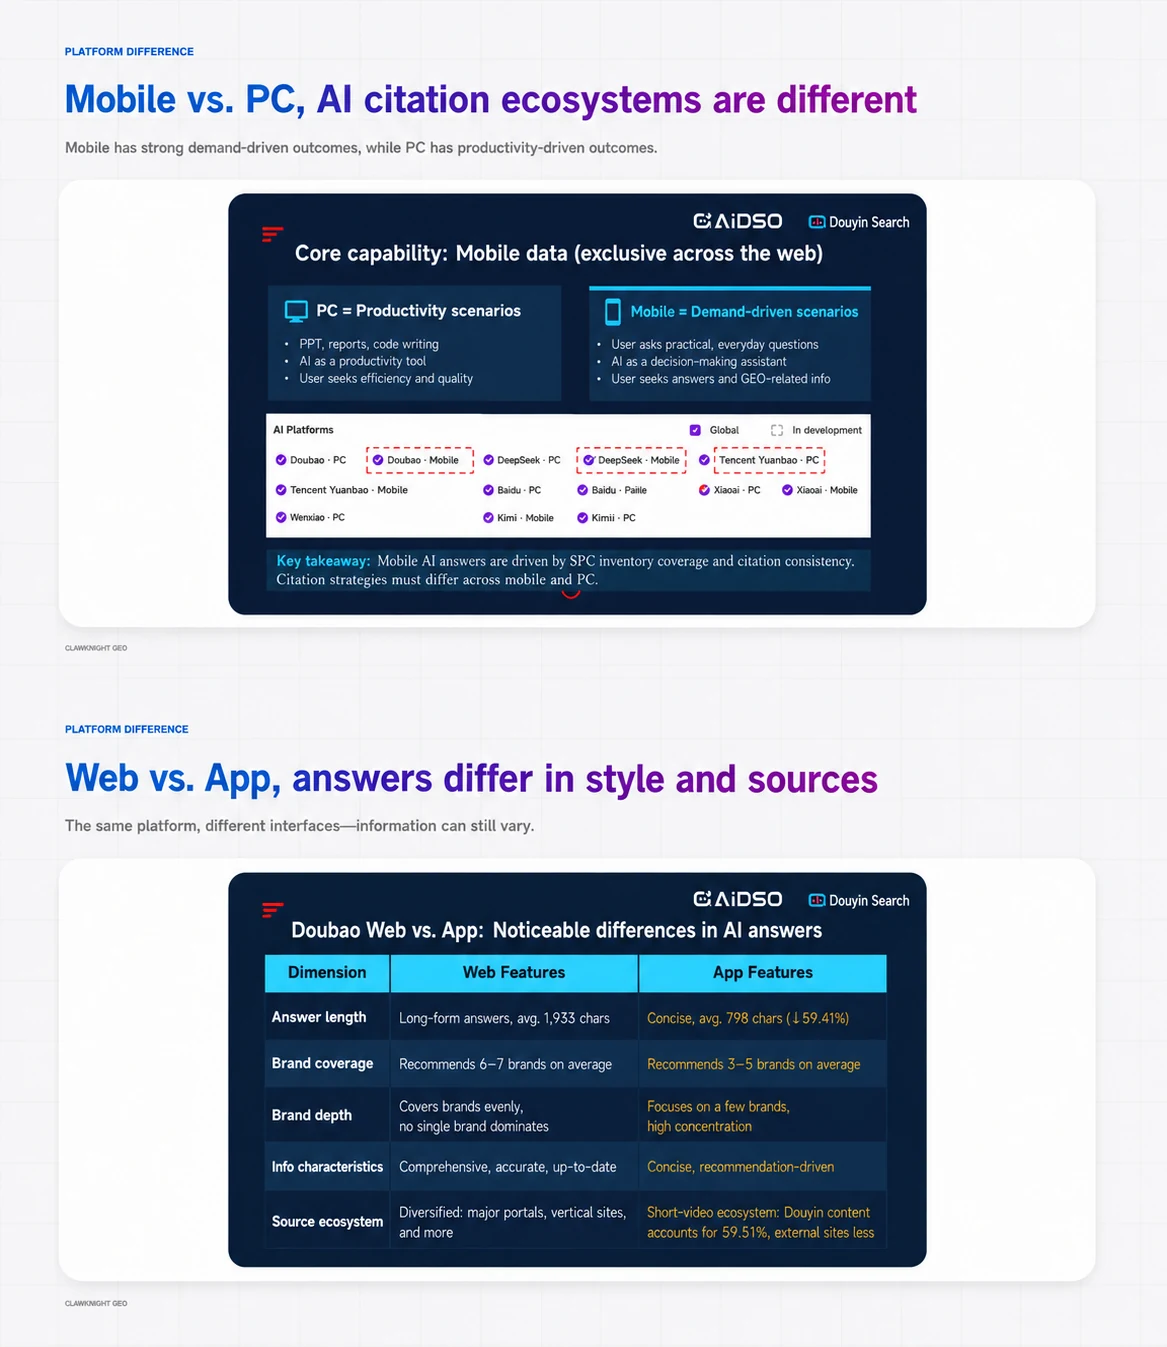
不同AI平台、不同终端,对信息源的偏好并不相同。
有的平台更容易引用公开网页,有的平台会放大短视频和社区内容,还有的平台在 App 端与 Web 端给出的答案就像两套不同的编辑部。
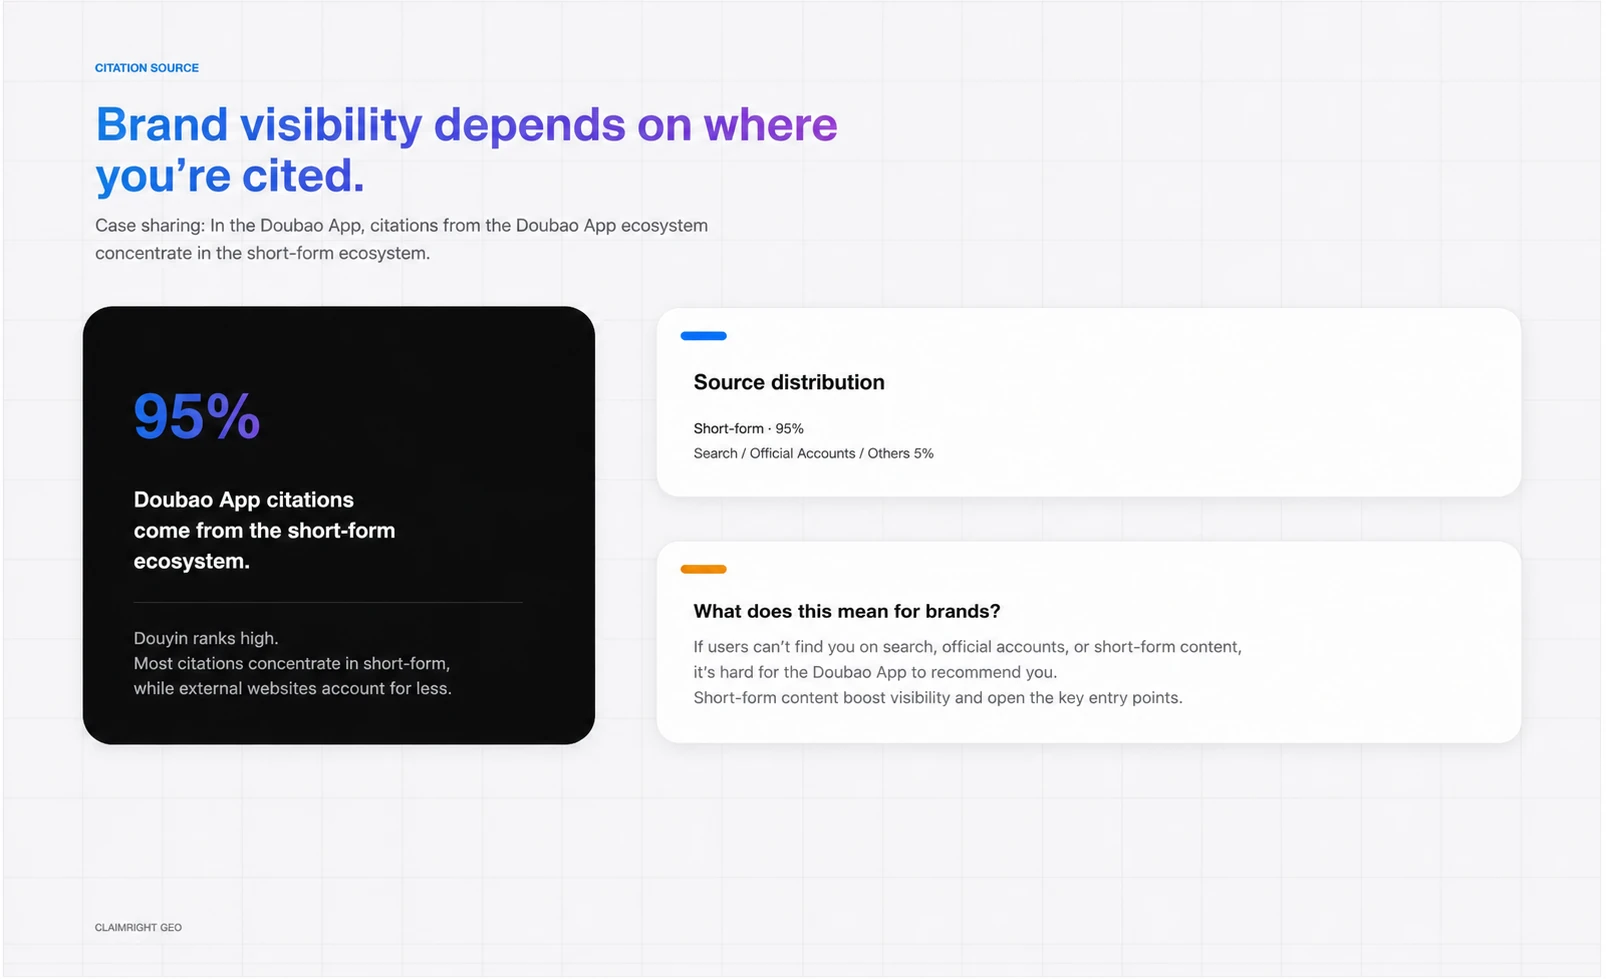
所以,品牌在其余AI里被推荐,并不自动等于它在所有AI里都被推荐。
单次截图更像一次路过的天气预报,能够提供线索,不足以判断整个季节。
很多所谓的GEO讨论里,最热闹的是术语,最安静的是数据。
原始回答可以堆出很厚的文件,也会显得很忙。真正有价值的工作,是把回答放回业务语境里:谁在问,她处于哪个决策阶段,问题对转化有什么影响,竞品的优势来自品牌、内容还是渠道。
没有这张地图,优化就像拿着扳手在黑屋里修机器。声音很专业,效果全靠缘分。
Part 3 | ClawHunt GEO 的第一步,是把问题变成一张品牌决策地图
GEO, Generative Engine Optimization,生成式引擎优化。
对 ClawHunt 来说,它首先是一套面向真实业务的洞察工作流。
ClawHunt GEO 的起点是品牌决策地图。客户最终得到的,是一份解释清楚这些回答意味着什么的专业判断。
我们会和客户一起拆解目标用户的决策过程:她的需求从哪里开始,最早会担心什么,会怎样比较方案,进入品牌评估时又需要哪些证据。随后,这些问题会聚合成不同层级的意图簇,形成有重点的研究池。
例如,前置认知类问题回答的是“我需不需要”。方案比较类问题回答的是“我该怎么选”。品牌评估类问题回答的是“为什么是你”。成交行动类问题则关心“下一步怎么做”。
每一层对品牌的意义不同,优先级也不同。
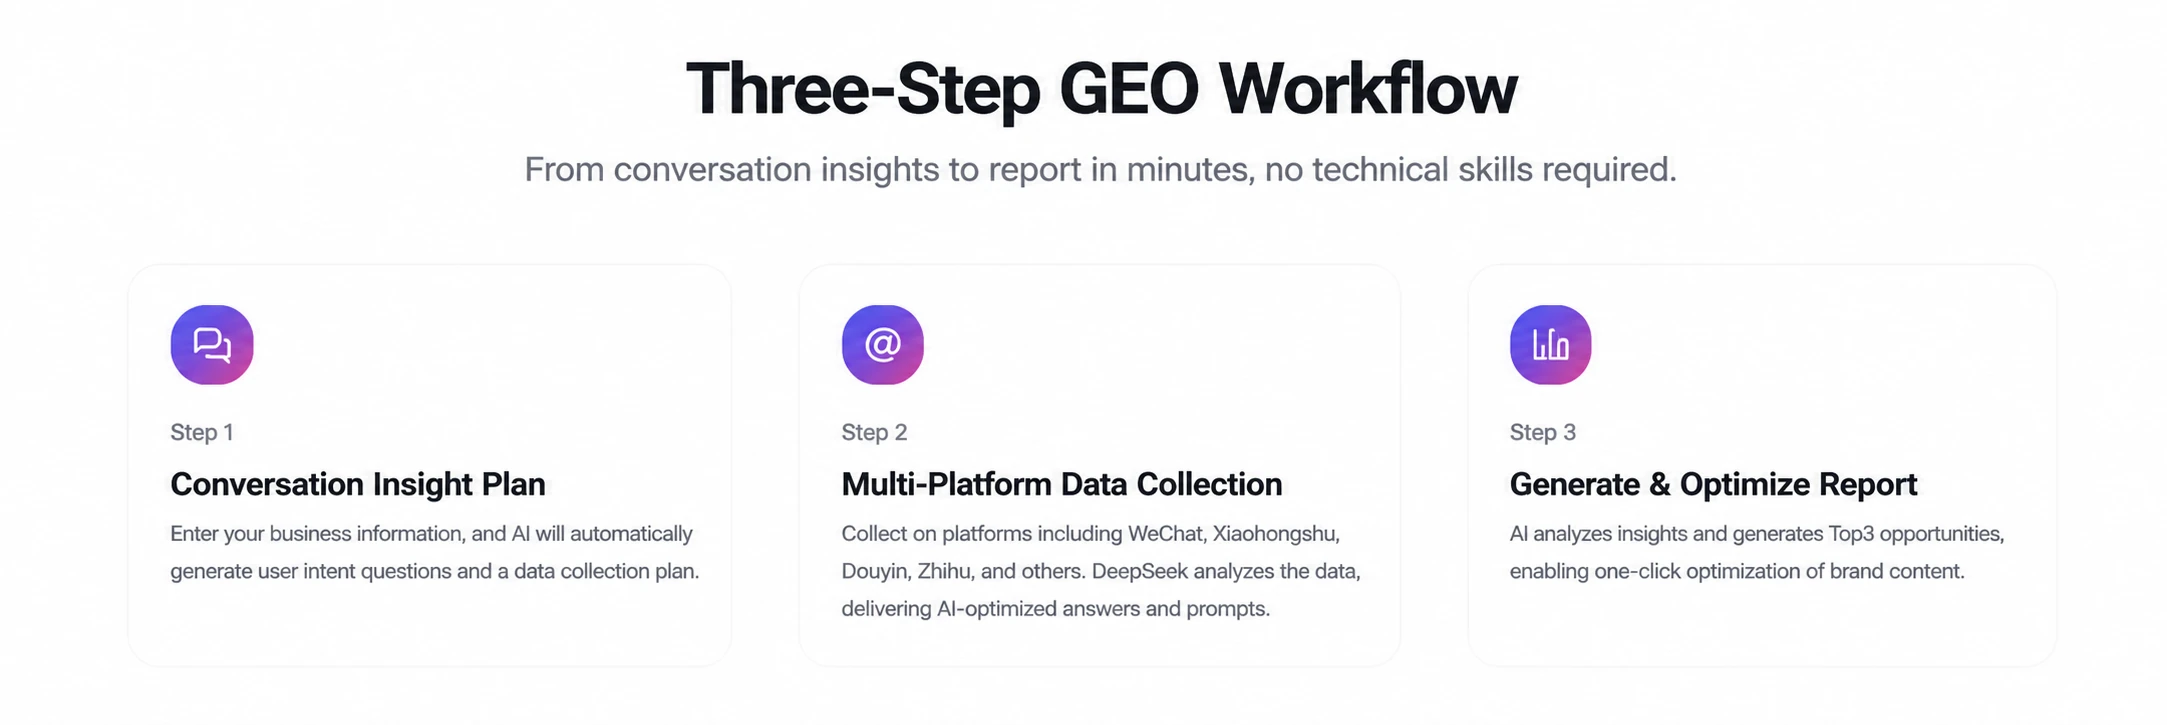
一个消费品牌在成交问题里没有出现,可能需要优化信息和转化入口。一个品牌在前置认知问题里长期缺席,往往意味着用户的信任教育还没开始。一个品牌被频繁提到却缺少推荐理由,则更需要补齐案例、解释和可验证的服务细节。
这些结论来自用户旅程、行业语境、品牌资产与 AI 回答的交叉分析,无法由一句“排名第几”单独得出。
当前,ClawHunt GEO 已经打通 12 个国内 AI采集端,覆盖豆包、干问、元宝、DeepSeek、KimiQ、百度 AI、抖音 AI、文心一言等 Web 与 App场景。
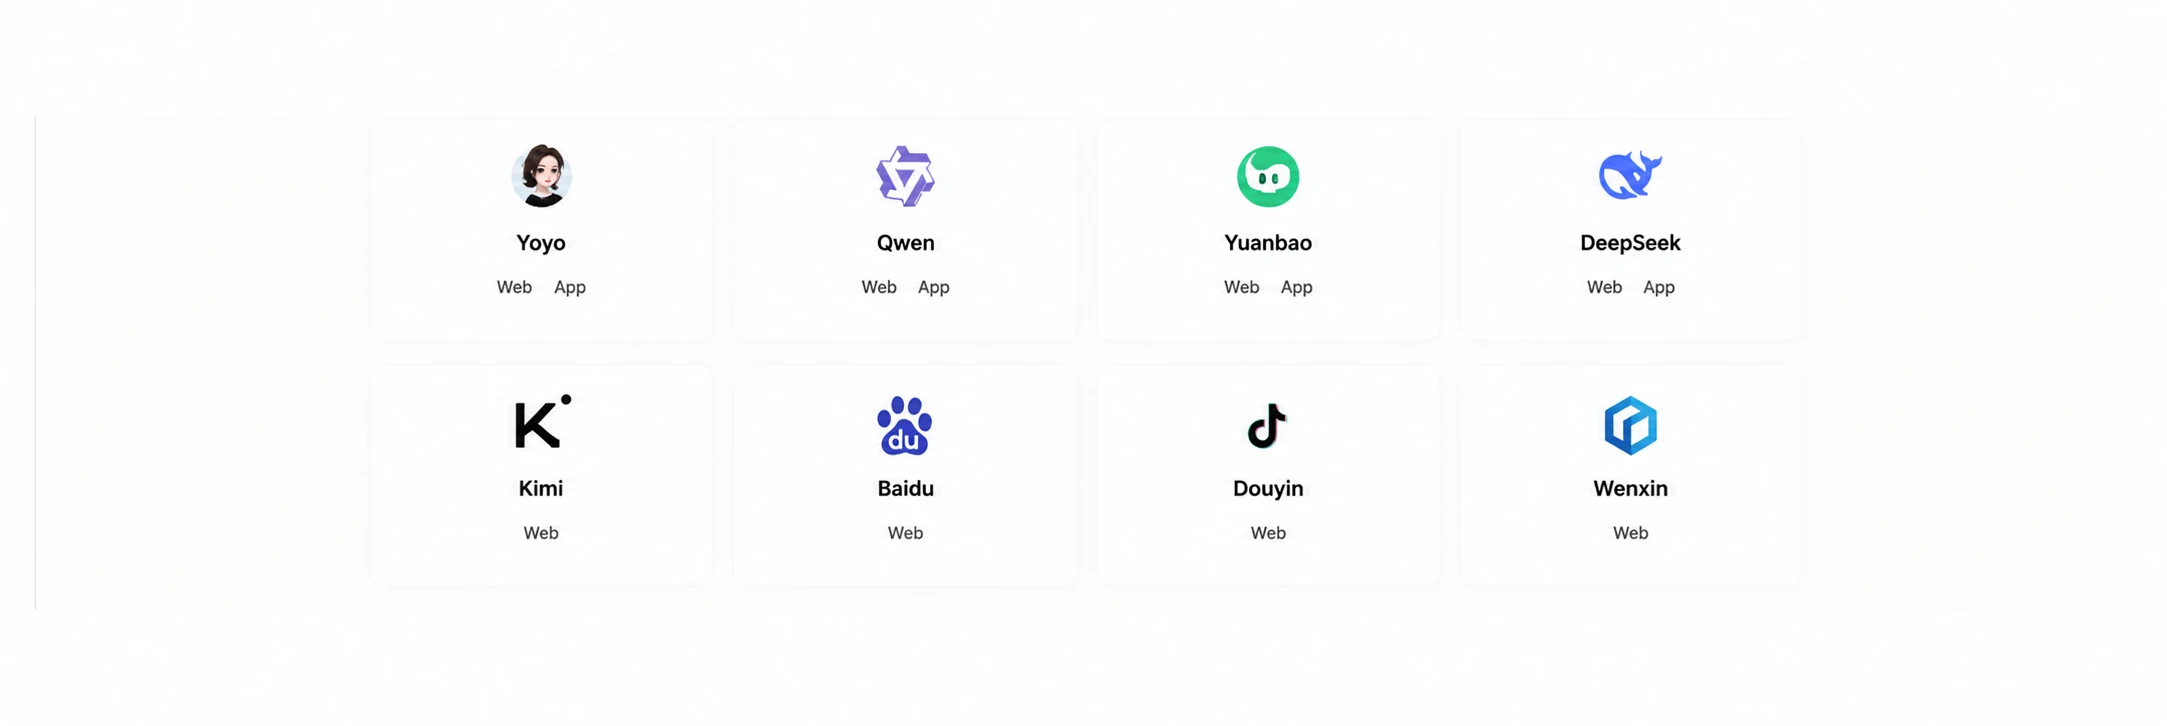
多平台采集只是第一层。
第二层是建立可比较的基线。我们会持续观察品牌在核心意图簇里的露出、Top 1与 Top 3 推荐表现、回答情感倾向、推荐理由、引用来源和竞品变化。这样,客户看到的不再是一串孤立的回答,而是一张会移动的品牌可见度地图。
第三层才是分析。
哪些问题值得优先处理,哪些内容缺口最影响信任,哪些平台正在成为主要入口,哪些竞品只是偶发出现,哪些已经形成稳定优势,这些都需要结合行业知识和实际业务判断。数据擅长把信号翻出来,专业团队负责把信号翻译成人能采取行动的语言。
这才是 ClawHunt GEO 提供的核心服务
客户得到的,是一套可解释的 AI 品牌洞察结果:哪里被看见,为什么被看见;哪里还在缺席,缺的究竟是内容、证据、渠道还是品牌表达;下一轮内容和运营资源应该优先投向哪里。
Part 4 |一份专业数据洞察,应该让团队少开一点无效会
ClawHunt GEO 的报告不止呈现数据,也要把数据变成决策线索。
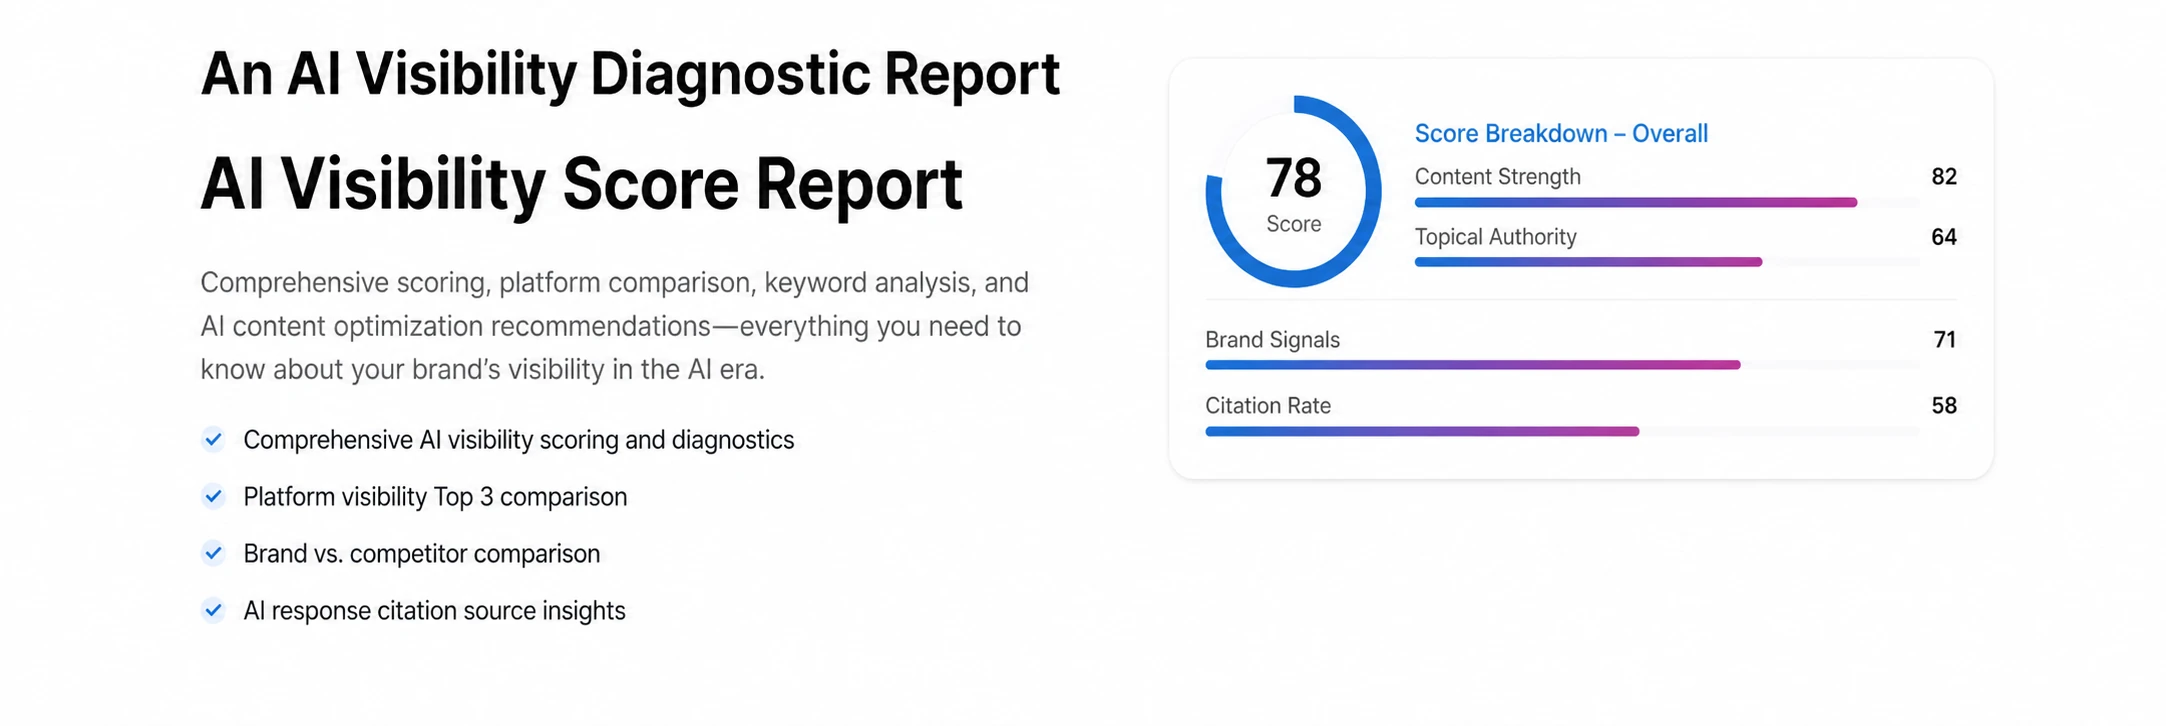
在品牌维度,我们会识别哪些核心场景已经建立可见度,哪些场景仍然空白,品牌在回答中的角色是被动出现、平级提名还是带理由的优先推荐。
在内容维度,我们会观察 AI 反复引用什么类型的材料。是官网知识页、专业文章、短视频、社区讨论、用户案例,还是第三方测评?这些来源共同构成了 AI认识品牌的证据链。
在竞品维度,我们会区分偶发露出和稳定优势。竞品一次出现在答案里,可能只是信息碰巧被抓到;当它持续出现在同一类高价值问题里,并且拥有更清晰的推荐理由时,才意味着品牌需要认真研究它的内容资产和表达结构。
在动作维度,我们会把洞察落回业务优先级。哪些内容需要立即补,哪些问题需要长期教育,哪些渠道值得加大投入,哪些现有内容应该被重写、重组或补充证据。
这套过程听上去有一点像医生读检查报告。
体温、血压、影像、化验单都很重要,但没有人会因为拿到了 10 张化验单,就觉得诊断已经完成。病灶在哪里,风险有多大,先处理什么,后观察什么,才是客户真正需要的答案。
GEO 也一样。
数据采集让品牌看见现象,问题建模帮助理解现象,专业分析才让团队知道下一步该做什么。三件事缺一件,报告都容易从“专业工具”滑向“漂亮仪表盘”。
ClawHunt GEO 提供体验检测,帮助品牌快速建立初步的AI 可见度基线。需要持续经营的团队,则可以进入托管服务,由我们完成意图地图梳理、跨平台监测、异常识别、月度洞察和内容优化建议。
客户无需每天手动向不同AI平台反复提问,也无需自己在几十份答案中找规律。更重要的是,客户不必把一个原本属于业务策略的问题,误当成一项单纯的数据录入工作。
这些监测上的问题,在我们的创始人与开发者社区里也被反复讨论。
写在最后|品牌需要知道,AI正在怎样替它说话
AI 搜索正在成为新的用户入口,但它不会替任何品牌凭空建立信誉。
它只会读取已经存在的内容、案例、评价、讨论和公开信息,再把这些碎片拼成一句看似完整的回答。
品牌如果长期缺席这些材料,AI 也只能给出一个模糊答案。品牌如果持续提供专业、具体、更新及时的内容,AI才有机会把这些信息递给正在提问的人。
这就是 GEO 的意义。
它让品牌第一次系统地看见:用户把问题交给 AI之后,自己的品牌被怎样描述,竞品被怎样推荐,内容又该从哪里开始补。
我们正在寻找首批愿意一起跑通“意图建模、可见度诊断、专业数据洞察、内容优化与效果验证”闭环的消费品牌
如果你想先看一眼 AI眼中的自己
访问https://clawhunt.store/geo
如果想为自己的品牌做一张决策地图,直接联系 GEO 团队就行。
想要了解更多信息 请在下方留言或私信
ClawHunt 公众号